1. ベクトル解析#
機械学習アルゴリズムの多くは、目的関数と呼ばれる関数の最小化に基づいている。例えば:
線形回帰(≒曲線のフィッティング)では、尤度が最大となるように重みパラメータを調整する。
ニューラルネットワークでは、損失関数が最小となるように重みやバイアスと呼ばれるパラメータを調整する。
クラスタリングでは、クラスタの中心がデータ点から最も近いように調整する。
オートエンコーダでは、入力データと復元されたデータの差が最小となるようにパラメータを調整する。
混合ガウスモデル(GMM)では、各ガウス分布の平均・分散を調整して尤度が最大となるようにする。
これらの問題は、勾配に基づく最適化アルゴリズムを用いて解くことが多い。
こうした目的関数を最小化するためには、一般に多変数の関数の微分を計算する必要がある。
上で関数\(f\)は\(D\)次元の実数値ベクトル\(\mathbf{x}\)を入力として受け取り、実数値を出力する関数である。
\(N\)個のデータ点を持つデータセット \(\{(x_i, y_i)\}_{i=1}^N\) が与えられた際、直線\(f(x)=ax+b\)で近似する線形回帰を考えるとする。この際、最小化すべき目的関数は次のように定義される。
ここで、\(y_i\)は\(i\)番目のデータ点の出力値、\(x_i\)は\(i\)番目のデータ点の入力値である。 データ点が固定されているとき、傾きと切片のパラメータ\((a, b)\)を調整して 目的関数\(f(a, b)\)を最小化することが目的となる。 これはまさに上の多変数関数の定義の特殊な場合になっている。
1.1. 一変数の微分#
関数\(f\)が一変数のとき、微分は次のように定義される。
1.1.1. テイラー展開#
定義: テイラー級数
関数\(f\)が点\(x_0\)の近傍で無限回連続微分可能(\(f \in C^\infty\))であるとき、\(f\)のテイラー級数は次のように定義される。
特に\(x_0 = 0\)のとき、テイラー級数はマクローリン級数と呼ばれる。
また、\(x_0\)のある近傍で級数が収束して\(f(x) = T_\infty(x)\)が成り立つとき、\(f\)は\(x_0\)でテイラー展開可能であるという。無限回微分可能であるだけでは、この一致は保証されない。
問題
多項式関数\(f(x) = x^3\)があるとき、\(x_0 = 1\)におけるテイラー多項式
の次数\(k\)に応じた展開を求め、テイラー級数がもとの関数\(f\)と一致することを確認せよ。4階以上の導関数\(f^{(n)}(x)\)(\(n\geq4\))が0であることは用いて良い。
1.1.2. 微分の基本的性質#
線形性:
\[ \frac{d}{dx}(af(x) + bg(x)) = a\frac{df}{dx} + b\frac{dg}{dx} \]積の微分:
\[ \frac{d}{dx}(f(x)g(x)) = f(x)\frac{dg}{dx} + g(x)\frac{df}{dx} \]商の微分:
\[ \frac{d}{dx}\left(\frac{f(x)}{g(x)}\right) = \frac{g(x)\frac{df}{dx} - f(x)\frac{dg}{dx}}{g(x)^2} \quad( g(x) \ne 0 ) \]合成関数の微分:
\[ \frac{d}{dx}f(g(x)) = f'(g(x))\frac{dg}{dx} \]
特に合成関数の微分は連鎖律(チェインルール)とも呼ばれ、ニューラルネットワークの逆伝播アルゴリズムにおいて重要な役割を果たす。
問題
以下の関数\(f,g\)で定義される合成関数\(h(x) = f(g(x))\)の微分を求めて、連鎖律を確認せよ。
1.2. 偏微分: 多変数への拡張#
ここまでの議論を、多変数関数に拡張しよう。
定義: 偏微分
\(n\)個の変数\(x_1, x_2, \ldots, x_n\)を持つ関数\(f(\mathbf{x})\)の偏微分は、次のように定義される。
本講義ノートでは、変数ベクトル\(\mathbf{x} = (x_1, \ldots, x_n)^T\)と同じ向きに、これらの偏微分をまとめた列ベクトルを勾配(gradient)と呼ぶ。
スカラー関数の\(\frac{\partial f}{\partial \mathbf{x}}\)も、この列ベクトル\(\nabla_{\mathbf{x}} f\)を表すものとする。文献によっては行ベクトルで表す規約もあるため、転置の有無に注意する。
1.2.1. 全微分と一次近似#
勾配は、入力を少し変えたときの関数値の変化を表す。 点\(\mathbf{x}\)の近傍で定義された関数\(f\)について、
と書けるとき、\(f\)は\(\mathbf{x}\)で全微分可能であるという。 ここで\(\|\cdot\|\)はユークリッドノルムであり、\(o(\|\Delta\mathbf{x}\|)\)は、 \(\Delta\mathbf{x}\to\mathbf0\)のときに\(\|\Delta\mathbf{x}\|\)で割った値が0に近づく誤差を表す。 一次の項
を全微分と呼ぶ。つまり、十分小さな変位なら、各変数による一次の変化を足すことで関数値の変化を近似できる。
偏微分は座標軸に沿った変化を調べるのに対して、全微分可能性は任意の方向からの変位を一つの線形写像で近似できることを要求する。 したがって、すべての偏微分が存在するだけでは全微分可能とは限らない。 十分条件として、すべての偏導関数がその点の近傍で存在し、連続ならば全微分可能である。 以後、この章で多変数関数を「微分可能」と呼ぶときは全微分可能を意味する。
1.2.2. 方向微分と勾配の向き#
微分可能な\(f\)に対して、単位ベクトル\(\mathbf{v}\)(\(\|\mathbf{v}\|=1\))の方向に進んだときの変化率を方向微分と呼ぶ。
この式では、出発点\(\mathbf{x}\)と方向\(\mathbf{v}\)を固定し、\(t\)だけを動かしている。 \(g(t)=f(\mathbf{x}+t\mathbf{v})\)とおけば、一本の直線に沿った関数値の変化を、一変数関数\(g\)の微分として調べることになる。 \(\left.\cdots\right|_{t=0}\)は、出発点\(\mathbf{x}\)に対応する\(t=0\)で微分の値を求める、という意味である。
\(\nabla f(\mathbf{x})\ne\mathbf0\)のとき、勾配と\(\mathbf{v}\)のなす角を\(\theta\)とすると、 この内積は\(\|\nabla f(\mathbf{x})\|\cos\theta\)となる。 したがって、単位長さあたりの増加率が最大となるのは勾配の向き、最小となるのは負の勾配の向きである。 これはユークリッドノルムで移動距離を測った場合の性質である。
下図では\(f(x_1,x_2)=x_1^2+2x_2^2\)、\(\mathbf{x}=(1,1)^T\)、\(\mathbf{v}=(5,1)^T/\sqrt{26}\)の例で、この対応を見る。
Show code cell source
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.patches import Arc

# 同じ二点を、左では入力空間、右では t と関数値の平面に描く。
x0 = np.array([1.0, 1.0])
v = np.array([5.0, 1.0]) / np.sqrt(26)  # 勾配の向きから離した単位ベクトル
h = 0.85


def f_on_line(t):
    points = x0[:, None] + v[:, None] * np.asarray(t).reshape(-1)
    return points[0]**2 + 2 * points[1]**2


g0, gh = f_on_line([0, h])
gradient = np.array([2 * x0[0], 4 * x0[1]])
slope = gradient @ v
next_point = x0 + h * v
blue, orange, gray = "#167c9c", "#c56320", "#687783"
red = "#b34360"
fig, (ax_input, ax_value) = plt.subplots(1, 2, figsize=(11, 4.7))

# (a) 入力空間: x から x + h v へ進む。
a1, a2 = np.meshgrid(np.linspace(0, 2.5, 251), np.linspace(0, 2.3, 231))
levels = [1, 2, 3, 5, 7, 10, 14, 18]
ax_input.contourf(a1, a2, a1**2 + 2 * a2**2,
                  levels=np.linspace(0, 18, 61), cmap="Blues", alpha=0.38,
                  antialiased=False)
contours = ax_input.contour(a1, a2, a1**2 + 2 * a2**2, levels=levels,
                           colors=gray, linewidths=0.7, alpha=0.65)
ax_input.clabel(contours, levels=[1, 3, 7, 14], fontsize=9, fmt="%g")
path_t = np.array([-1.2, 1.65])
path = x0[:, None] + v[:, None] * path_t
ax_input.plot(*path, color=blue, lw=1.6, ls="--")
ax_input.annotate("", xy=next_point, xytext=x0,
                  arrowprops={"arrowstyle": "->", "color": blue, "lw": 2.8,
                              "shrinkA": 0, "shrinkB": 0,
                              "mutation_scale": 16}, zorder=4)
# 勾配は向きが分かるように長さを調整し、v との間に角度 theta を描く。
gradient_tip = x0 + 1.04 * gradient / np.linalg.norm(gradient)
ax_input.annotate("", xy=gradient_tip, xytext=x0,
                  arrowprops={"arrowstyle": "->", "color": red, "lw": 2.4,
                              "shrinkA": 0, "shrinkB": 0,
                              "mutation_scale": 16}, zorder=4)
ax_input.annotate(r"$\nabla f(\mathbf{x})$", gradient_tip,
                  xytext=(0, 9), textcoords="offset points", ha="center",
                  fontsize=13, color=red)
v_angle = np.degrees(np.arctan2(v[1], v[0]))
grad_angle = np.degrees(np.arctan2(gradient[1], gradient[0]))
ax_input.add_patch(Arc(x0, 0.76, 0.76, theta1=v_angle, theta2=grad_angle,
                       color=red, lw=1.6, zorder=6))
mid_angle = np.radians((v_angle + grad_angle) / 2)
theta_label = x0 + 0.54 * np.array([np.cos(mid_angle), np.sin(mid_angle)])
ax_input.text(*theta_label, r"$\theta$", ha="center", va="center",
               fontsize=15, color=red)
ax_input.scatter(*x0, s=52, color="#222222", zorder=5)
ax_input.scatter(*next_point, s=52, color=blue, zorder=5)
ax_input.annotate(r"$\mathbf{x}$  $(t=0)$", x0, xytext=(-8, -25),
                  textcoords="offset points", ha="right", fontsize=12)
ax_input.annotate(r"$\mathbf{x}+h\mathbf{v}$", next_point,
                  xytext=(4, -25), textcoords="offset points", fontsize=12, color=blue)
ax_input.text(1.38, 0.93, r"$h\mathbf{v}$", fontsize=14, color=blue)
ax_input.text(0.16, 1.96, r"$\mathbf{x}+t\mathbf{v}$", fontsize=14, color=blue)
ax_input.text(0.16, 1.74, r"$\|\mathbf{v}\|=1$", fontsize=11, color=blue)
ax_input.set(xlim=(0, 2.5), ylim=(0, 2.3), aspect="equal",
             xlabel=r"$x_1$", ylabel=r"$x_2$",
             title=r"(a) Input space: $f(x_1,x_2)=x_1^2+2x_2^2$")
ax_input.set_xticks([0, 1, 2])
ax_input.set_yticks([0, 1, 2])

# (b) 経路上の値: t だけの関数 g(t) の接線を t=0 で求める。
t = np.linspace(-0.65, 1.35, 401)
ax_value.plot(t, f_on_line(t), color=blue, lw=2.4, label=r"$g(t)$")
ax_value.plot(t, g0 + slope * t, color=orange, lw=2,
              label="Tangent at $t=0$")
ax_value.plot([0, h], [g0, gh], color=gray, lw=1.4, ls="--",
              label="Secant")
ax_value.plot([0, h, h], [g0, g0, gh], color=gray, lw=1.2, ls=":")
ax_value.scatter([0, h], [g0, gh], s=52, color=["#222222", blue], zorder=5)
ax_value.annotate(r"$g(0)=f(\mathbf{x})$", (0, g0), xytext=(-12, 12),
                  textcoords="offset points", ha="right", fontsize=11)
ax_value.annotate(r"$g(h)=f(\mathbf{x}+h\mathbf{v})$", (h, gh),
                  xytext=(-10, 17), textcoords="offset points", ha="right",
                  fontsize=11, color=blue)
ax_value.text(h / 2, g0 - 0.5, r"$h$", ha="center", fontsize=12, color=gray)
ax_value.text(h + 0.07, (g0 + gh) / 2, "$g(h)$\n$-g(0)$",
               va="center", fontsize=11, color=gray)
ax_value.text(0.04, 0.96, "Slope at $t=0$\n" +
               r"$g'(0)=D_{\mathbf{v}}f(\mathbf{x})=\nabla f(\mathbf{x})^T\mathbf{v}$" + "\n" +
               r"$\qquad=\|\nabla f(\mathbf{x})\|\cos\theta$",
               transform=ax_value.transAxes, va="top", fontsize=12, color=orange,
               bbox={"boxstyle": "round,pad=0.45", "fc": "#fff5ea", "ec": "none"})
ax_value.axvline(0, color="0.8", lw=0.8, zorder=0)
ax_value.set(xlim=(-0.65, 1.35), ylim=(-0.5, 12), xlabel=r"$t$",
             ylabel=r"$g(t)$", title=r"(b) One-variable function: $g(t)=f(\mathbf{x}+t\mathbf{v})$")
ax_value.set_xticks([-0.5, 0, h], [r"$-0.5$", r"$0$", r"$h$"])
ax_value.legend(loc="lower right", fontsize=9, framealpha=0.95)
for ax in (ax_input, ax_value):
    ax.spines[["top", "right"]].set_visible(False)
fig.tight_layout(w_pad=3)
plt.show()
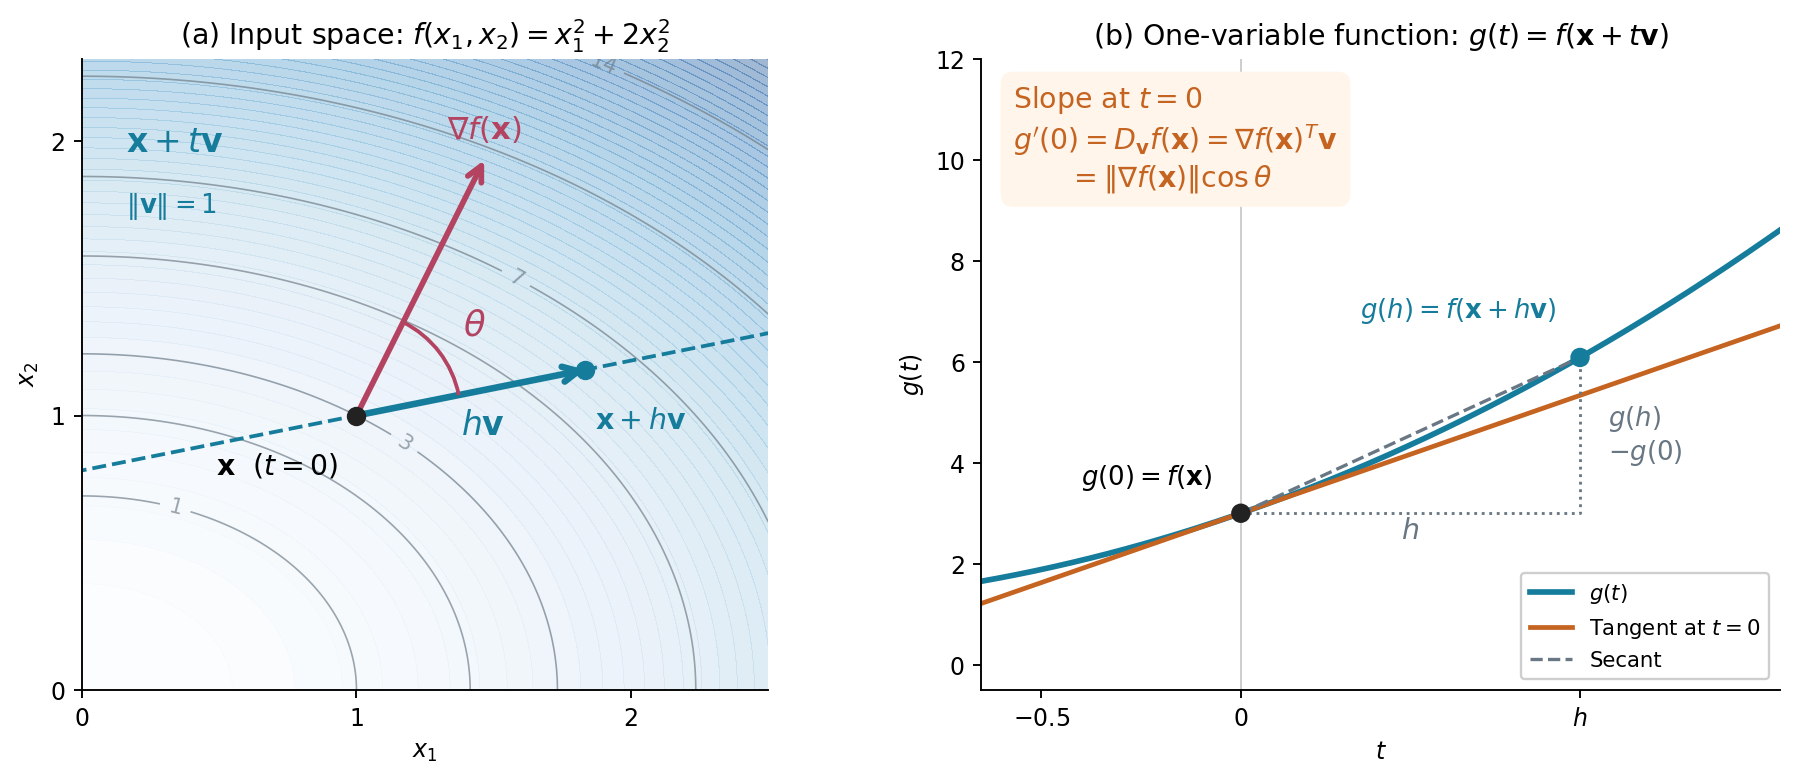
左図:入力空間での移動。 黒点\(\mathbf{x}\)から青い矢印の方向へ進むと、青点\(\mathbf{x}+h\mathbf{v}\)に着く。背景の曲線は\(f\)の等高線である。赤い矢印は勾配\(\nabla f(\mathbf{x})\)の向きを表し、青い矢印とのなす角が\(\theta\)である(\(h>0\)なので\(h\mathbf{v}\)と\(\mathbf{v}\)は同じ向き)。勾配の矢印の長さは、見やすいように調整している。図では\(h>0\)であり、\(\|\mathbf{v}\|=1\)なので移動距離は\(h\)になる。
右図:その経路に沿った関数値。 同じ二点を、横軸\(t\)、縦軸\(g(t)=f(\mathbf{x}+t\mathbf{v})\)で描く。灰色の破線(割線)の傾きは\(\{g(h)-g(0)\}/h\)であり、\(h\)を0に近づけた極限が、黒点でのオレンジ色の接線の傾きになる。
つまり、方向微分はこの接線の傾きであり、一変数の微分の定義から
と表せる。さらに、連鎖律と\(\frac{d}{dt}(\mathbf{x}+t\mathbf{v})=\mathbf{v}\)を用いると、 \(g'(0)=\nabla f(\mathbf{x})^T\mathbf{v}\)となり、最初の式の右辺につながる。
例えば、\(\Delta\mathbf{x}=-\eta\nabla f(\mathbf{x})\)とおくと、勾配がゼロでない点では
が十分小さな\(\eta>0\)について成り立つ。これが勾配降下法の根拠である。 移動幅\(\eta\)が大きすぎると、この減少は保証されない。 具体的な更新方法は最適化の章で扱う。
また、等高線\(f(\mathbf{x})=c\)に沿う滑らかな曲線\(\mathbf{x}(t)\)を考えると、関数値が変わらないため、
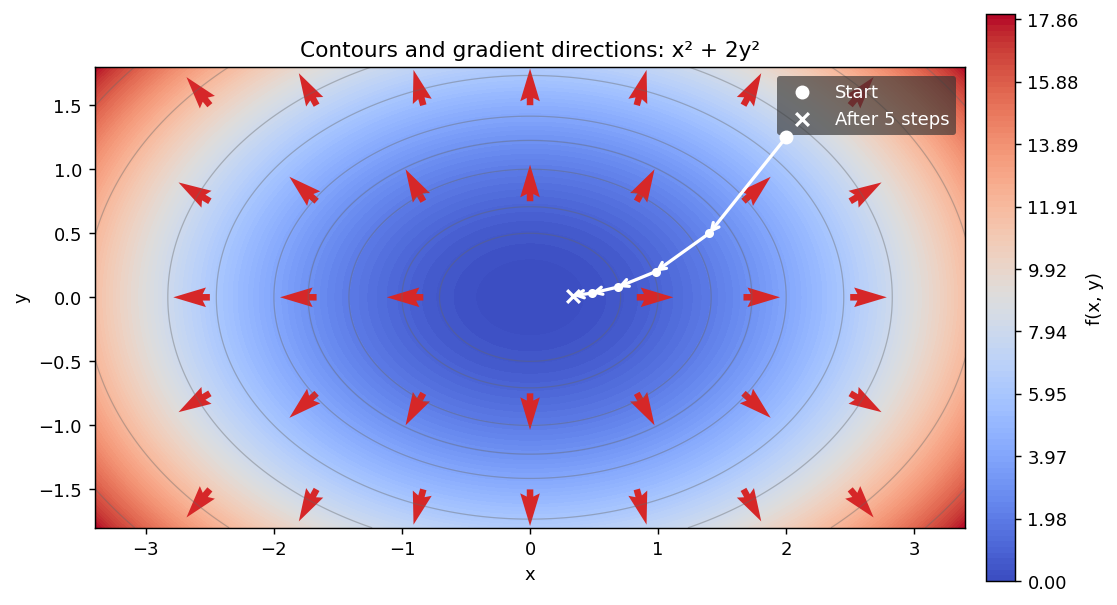
となる。勾配がゼロでない点では、勾配は等高線の接線に直交する。 次の図では\(f(x,y)=x^2+2y^2\)の値を背景の色で表し、半透明のグレーの等高線と、勾配\((2x,4y)^T\)を重ねる。 赤い矢印は勾配の向きを表し、長さは見やすいように揃えている。 白い点と矢印は、点\((2,1.25)\)を出発点として、移動幅\(\eta=0.15\)で勾配降下法を5ステップ適用した経路を表す。白い丸が出発点、小さな白い点が途中の各ステップ、白い×印が5ステップ後の位置である。
Show code cell source
import numpy as np
import matplotlib.pyplot as plt

x_values = np.linspace(-3.4, 3.4, 361)
y_values = np.linspace(-1.8, 1.8, 241)
gx, gy = np.meshgrid(x_values, y_values)
fig, ax = plt.subplots(figsize=(9, 4.8))
values = gx**2 + 2 * gy**2
contours = ax.contourf(gx, gy, values,
                       levels=np.linspace(0, values.max(), 101),
                       cmap="coolwarm", antialiased=False)
ax.contour(gx, gy, values, levels=[0.5, 1, 2, 3, 4, 6, 8, 12, 16],
           colors="0.4", alpha=0.4, linewidths=0.7)
fig.colorbar(contours, ax=ax, label="f(x, y)", pad=0.02)

qx, qy = np.meshgrid(np.linspace(-2.5, 2.5, 7), np.linspace(-1.5, 1.5, 5))
grad_x, grad_y = 2 * qx, 4 * qy
grad_norm = np.hypot(grad_x, grad_y)
nonzero = grad_norm > 0
ax.quiver(qx[nonzero], qy[nonzero],
          grad_x[nonzero] / grad_norm[nonzero],
          grad_y[nonzero] / grad_norm[nonzero],
          angles="xy", scale_units="xy", scale=3.5, color="tab:red")

# 移動の各段階が見えるように、原点から少し離れた点を出発点とする。
point = np.array([2.0, 1.25])
eta = 0.15
n_steps = 5
trajectory = [point.copy()]
for _ in range(n_steps):
    current = trajectory[-1]
    gradient = np.array([2 * current[0], 4 * current[1]])
    trajectory.append(current - eta * gradient)
trajectory = np.array(trajectory)

for current, following in zip(trajectory[:-1], trajectory[1:]):
    ax.annotate("", xy=following, xytext=current,
                arrowprops={"arrowstyle": "->", "color": "white", "lw": 1.8,
                            "shrinkA": 0, "shrinkB": 0}, zorder=5)
ax.scatter(*trajectory[0], color="white", s=45, label="Start", zorder=6)
ax.scatter(trajectory[1:-1, 0], trajectory[1:-1, 1], color="white", s=16, zorder=6)
ax.scatter(*trajectory[-1], color="white", marker="x", s=50, linewidths=1.8,
           label=f"After {n_steps} steps", zorder=6)
ax.set(xlabel="x", ylabel="y", title="Contours and gradient directions: x² + 2y²",
       xlim=(-3.4, 3.4), ylim=(-1.8, 1.8), aspect="equal")
ax.legend(loc="upper right", facecolor="0.2", edgecolor="none",
          framealpha=0.65, labelcolor="white")
fig.tight_layout()
plt.show()
1.2.3. 多変数関数の連鎖律#
多変数の場合のチェインルールを整理しておこう。
微分可能な二変数関数\(f: \mathbb{R}^2 \to \mathbb{R}\)と、\(t\)に依存する変数\(\mathbf{x}(t) = (x_1(t), x_2(t))^T\)に対して、合成関数の微分は勾配と\(\frac{d\mathbf{x}}{dt}\)の内積で表される。
式(1.3)に\(d\mathbf{x}=(d\mathbf{x}/dt)dt\)を代入し、\(dt\)の係数を比べるとこの式が得られる。 ここで、\(f\)の偏微分は\(\mathbf{x}(t)\)で評価する。勾配そのものは列ベクトルであり、内積を取るために転置している。
あるいは、\(\mathbf{x}\)が\(\mathbf{u} = (s,t)^T\)に依存するとき、次節で定義するヤコビ行列を用いて
と書くと、合成関数\(h(\mathbf{u}) = f(\mathbf{x}(\mathbf{u}))\)の勾配は次の列ベクトルになる。
右辺の\(\nabla_{\mathbf{x}} f\)は\(\mathbf{x}(\mathbf{u})\)で評価する。一般に\(\mathbf{u}\in\mathbb{R}^k\)、\(\mathbf{x}\in\mathbb{R}^n\)なら、\(\mathbf{J}_{\mathbf{x}}\in\mathbb{R}^{n\times k}\)なので、\(\mathbf{J}_{\mathbf{x}}^T\nabla_{\mathbf{x}}f\in\mathbb{R}^{k\times 1}\)となる。
1.3. ベクトル値関数の微分#
実数値関数\(f: \mathbb{R}^n \to \mathbb{R}\)に対する偏微分と勾配を、より一般のベクトル値関数\(\mathbf{f}: \mathbb{R}^n \to \mathbb{R}^m\)に拡張する。
このベクトル値関数の変数\(x_i (i= 1, \ldots, n)\)に関する偏微分は次のように定義される。
各入力変数\(x_i\)について得られる\(m\)次元の列ベクトルを横に並べたものを、ヤコビ行列と呼ぶ。出力成分を行、入力成分を列に対応させる。
ベクトル値関数\(\mathbf{f}: \mathbb{R}^n \to \mathbb{R}^m\)のヤコビ行列を\(\mathbf{J}_{\mathbf{f}}\)と書く:
各行は、スカラー関数\(f_i\)の列勾配を転置したものである。
とくに、スカラー関数\(f\)のヤコビ行列は\(\mathbf{J}_f = (\nabla_{\mathbf{x}} f)^T \in \mathbb{R}^{1\times n}\)であり、列ベクトルである勾配とは区別する。
1.3.1. ヤコビ行列による局所線形近似#
微分可能なベクトル値関数\(\mathbf{f}:\mathbb{R}^n\to\mathbb{R}^m\)では、 スカラー関数の一次近似が次のように拡張される。
ここで誤差は\(m\)次元ベクトルであり、そのノルムを\(\|\Delta\mathbf{x}\|\)で割ると0に近づく。 ヤコビ行列は、入力の小さな変化を出力の変化へ写す線形写像である。 \(\mathbf{J}_{\mathbf{f}}\in\mathbb{R}^{m\times n}\)に\(\Delta\mathbf{x}\in\mathbb{R}^{n\times1}\)を掛けるので、 出力の変化は\(m\times1\)の列ベクトルになる。
例えば、\(\mathbf{f}(x,y)=(x^2+y,xy)^T\)では、
点\((1,2)\)から\(\Delta\mathbf{x}=(h,k)^T\)だけ動くと、一次近似による出力の変化は\((2h+k,2h+k)^T\)となる。 したがって、1次の変化はJacobi行列で表現できる。 実際の変化は\((2h+k+h^2,2h+k+hk)^T\)なので、その差は二次の項\((h^2,hk)^T\)である。
1.3.2. ベクトル値関数どうしの連鎖律#
微分可能な\(\mathbf{f}:\mathbb{R}^n\to\mathbb{R}^m\)と\(\mathbf{g}:\mathbb{R}^m\to\mathbb{R}^p\)を合成する。 途中の変数を\(\mathbf{z}=\mathbf{f}(\mathbf{x})\)、合成関数を\(\mathbf{h}=\mathbf{g}\circ\mathbf{f}\)と書くと、計算の流れは
となる。\(\mathbf{x}\)を少し変えると、まず\(\mathbf{z}\)が変わり、その変化を通じて出力\(\mathbf{h}\)が変わる。 式(1.3)をベクトル値関数に拡張し、先ほどの局所線形近似を全微分で書けば、
である。2行目の\(d\mathbf{z}\)に1行目を代入すると、
となる。一方、合成関数を直接微分すれば\(d\mathbf{h}=\mathbf{J}_{\mathbf{h}}(\mathbf{x})\,d\mathbf{x}\)である。 任意の\(d\mathbf{x}\)に対して両者が一致するため、次の連鎖律を得る。
行列は右から作用するので、先に適用する\(\mathbf{f}\)のヤコビ行列が右側に来る。 また、\(\mathbf{g}\)への入力は\(\mathbf{x}\)ではなく\(\mathbf{z}=\mathbf{f}(\mathbf{x})\)なので、 \(\mathbf{J}_{\mathbf{g}}\)もその点で評価する。 行列のサイズは\((p\times m)(m\times n)=p\times n\)となり、入力\(n\)成分の変化を出力\(p\)成分の変化に写している。
成分ごとに確認する。 出力の第\(k\)成分は\(h_k(\mathbf{x})=g_k(f_1(\mathbf{x}),\ldots,f_m(\mathbf{x}))\)である。 入力\(x_i\)を変えると、中間変数\(z_1,\ldots,z_m\)のそれぞれを通じて\(h_k\)が変わる。 多変数の連鎖律では、それらの寄与をすべて足すので、
となる。ここで\(\partial g_k/\partial z_j\)は\(\mathbf{J}_{\mathbf{g}}\)の\((k,j)\)成分、 \(\partial f_j/\partial x_i\)は\(\mathbf{J}_{\mathbf{f}}\)の\((j,i)\)成分である。 したがって、右辺は行列積の定義そのものであり、
とまとめられる。行列積で中間の添字\(j\)について和を取ることは、すべての中間変数を通る変化を足し合わせることに対応する。
出力がスカラーの場合は、列勾配の式に直す。 \(\mathbf{g}\)の代わりに損失関数\(L:\mathbb{R}^m\to\mathbb{R}\)を考えると、\(p=1\)であり、 \(\mathbf{J}_L=(\nabla_{\mathbf{z}}L)^T\)は\(1\times m\)の行ベクトルである。 同様に、\(\mathbf{J}_{L\circ\mathbf{f}}=(\nabla_{\mathbf{x}}(L\circ\mathbf{f}))^T\)なので、連鎖律は
となる。両辺を転置し、積の転置では順序が逆になる\((AB)^T=B^TA^T\)を使うと、
が得られる。右辺のサイズは\((n\times m)(m\times1)=n\times1\)で、入力\(\mathbf{x}\)に関する列勾配になっている。 入力の変化を出力へ伝えるときは\(\mathbf{J}_{\mathbf{f}}\)を使い、出力側の損失の勾配から入力側の勾配を求めるときは\(\mathbf{J}_{\mathbf{f}}^T\)を使う。 誤差逆伝播法の章では、この式を各層に適用し、成分ごとの漸化式とヤコビ行列を用いた表現を示す。
1.3.3. 変数変換と面積・体積の変化#
入力と出力の次元が等しいとき、ヤコビ行列の行列式の絶対値は局所的な体積の拡大率を表す。 これは重積分の変数変換や確率密度の変換に現れる。
2次元では、領域\(A\)から領域\(B\)への一対一の変数変換\(T:(x,y)\mapsto(u,v)\)を考える。 \(T\)とその逆変換は連続微分可能であり、\(\det\mathbf{J}\ne0\)とする。
この\(\mathbf{J}\)は\((x,y)\)から\((u,v)\)への変換なので、面積要素の関係は
である。逆変換を\((x,y)=(x(u,v),y(u,v))\)と書くと、積分可能な関数\(f\)に対して
となる。どちら向きの変換のヤコビ行列かを確認することが大切である。
以下では\(A=[0,1]\times[0,1]\)とし、同じ正方形が二つの変換でどう写るかを比較する。 図の細い格子線と濃い小領域も、変換によって\(A\)から\(B\)へ写されている。
座標軸ごとのスケール変換。 \(u=2x,\ v=3y\)なら \(\mathbf{J}=\operatorname{diag}(2,3)\)、\(|\det\mathbf{J}|=6\)である。 \(A\)の像\(B=[0,2]\times[0,3]\)は面積6の長方形となり、 式(1.12)より\(dx\,dy=\frac16du\,dv\)だから、 \(\int_A1\,dx\,dy=\int_B\frac16\,du\,dv=1\)と確認できる。
\(x,y\)が結合する変換。 \(u=2x+y,\ v=x+2y\)では、両方の出力が\(x,y\)に依存する。
\(B\)は頂点\((0,0),(2,1),(3,3),(1,2)\)を持つ平行四辺形となり、面積は3である。 逆変換は\(x=(2u-v)/3,\ y=(2v-u)/3\)なので、 式(1.13)では逆変換側の係数\(1/3\)を使い、 \(\int_A1\,dx\,dy=\int_B\frac13\,du\,dv=1\)となる。 この例は、座標軸が斜めに写っても面積の倍率はヤコビ行列の行列式で決まることを示す。
3次元でも同様に、微小体積の倍率は \(\left|\det\bigl(\partial(u,v,w)/\partial(x,y,z)\bigr)\right|\)である。
1.4. \(\clubsuit\) ヘッセ行列と二次近似#
2階連続微分可能な実数値関数\(f: \mathbb{R}^n \to \mathbb{R}\)に対して、各変数で2回偏微分した行列をヘッセ行列(Hessian matrix)と呼ぶ。
\(f\)が2階連続微分可能ならば、偏微分の順序を入れ替えても結果は変わらない。このため、ヘッセ行列は対称行列になる。 ヘッセ行列は、関数\(f\)の2次微分に関する情報を提供し、最適化問題において重要な役割を果たす。
1.4.1. 多変数関数のテイラー展開#
\(f\)が\(\mathbf{x}\)の近傍で2階連続微分可能なら、一変数のテイラー展開は次のように拡張される。
誤差\(o(\|\Delta\mathbf{x}\|^2)\)は、\(\|\Delta\mathbf{x}\|^2\)で割ると0に近づく項である。 勾配が一次の変化を、ヘッセ行列が二次の変化を表す。 二変数では二次の項は
となる。混合偏微分の項も含まれることに注意する。
単位ベクトル\(\mathbf{v}\)に沿う一変数関数\(\phi(t)=f(\mathbf{x}+t\mathbf{v})\)を考えると、
したがって、\(\mathbf{v}^T\boldsymbol{H}_f\mathbf{v}\)は、その方向に沿った二階微分である。 \(\mathbf{v}\)がヘッセ行列の単位固有ベクトルで、対応する固有値が\(\lambda\)なら、\(\phi''(0)=\lambda\)となる。 この意味で、固有値は各固有ベクトル方向の曲がり方を表す。
1.4.2. 停留点と極値の判定#
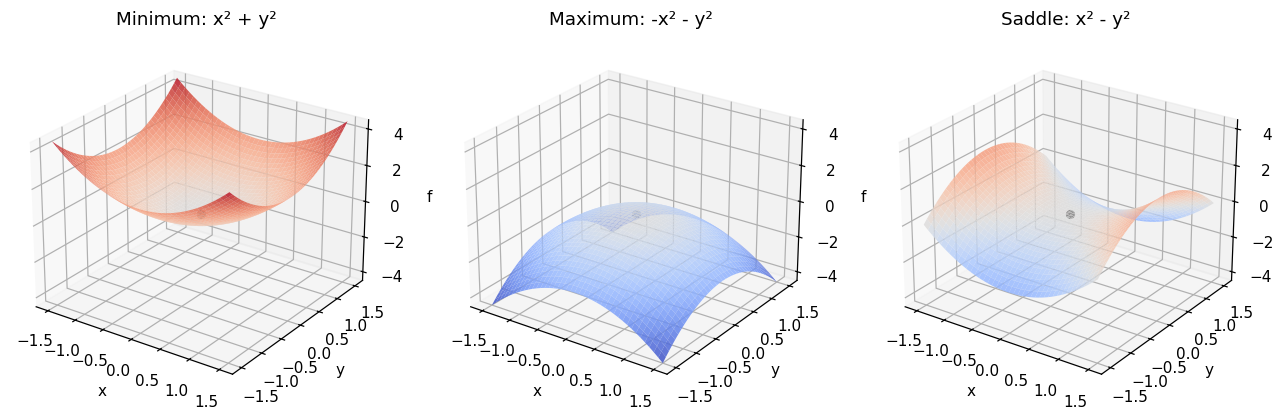
視覚的には、ヘッセ行列は関数\(f\)の曲率を表し、関数の極値(最小値・最大値)の性質を理解するのに役立つ。
定義域の内部にある微分可能な関数の局所最小点・局所最大点では\(\nabla f=\mathbf0\)となる。 この条件を満たす点を停留点と呼ぶが、停留点が極値を与えるとは限らない。 停留点では多変数テイラー展開の一次の項が消えるため、二次の項の符号が重要になる。
2階連続微分可能な関数の停留点において、ヘッセ行列の固有値がすべて正なら狭義の局所最小点、すべて負なら狭義の局所最大点である。正と負が混在していれば鞍点(saddle point)である。 停留点でない点では、ヘッセ行列の符号だけで極値を判定することはできない。
関数 |
原点でのヘッセ行列 |
固有値 |
原点の性質 |
|---|---|---|---|
\(x^2+y^2\) |
\(\operatorname{diag}(2,2)\) |
\(2,2\) |
狭義の最小点 |
\(-x^2-y^2\) |
\(\operatorname{diag}(-2,-2)\) |
\(-2,-2\) |
狭義の最大点 |
\(x^2-y^2\) |
\(\operatorname{diag}(2,-2)\) |
\(2,-2\) |
鞍点 |
すべての固有値が正の対称行列を正定値と呼ぶ。これは\(\Delta\mathbf x\ne\mathbf0\)なら \(\Delta\mathbf x^TH_f\Delta\mathbf x>0\)となることを意味し、停留点の周りで関数値が増えることにつながる。
すべての固有値が0以上の対称行列を半正定値、0以下のものを半負定値と呼ぶ。 ヘッセ行列が半正定値・半負定値でゼロ固有値を含む場合は、二次の情報だけでは判定できない。 例えば\(x^4+y^4\)、\(-x^4-y^4\)、\(x^4-y^4\)は原点で勾配もヘッセ行列もゼロだが、原点はそれぞれ最小点・最大点・鞍点である。 なお、ゼロ固有値があっても正と負の固有値が混在していれば鞍点と判定できる。
Show code cell source
# 鞍点の例をみるのに、x^2 - y^2 のグラフを描いてみる。
import numpy as np
import matplotlib.pyplot as plt

grid = np.linspace(-1.5, 1.5, 81)
sx, sy = np.meshgrid(grid, grid)
fig = plt.figure(figsize=(12, 3.8))
examples = [(sx**2 + sy**2, "Minimum: x² + y²"),
            (-sx**2 - sy**2, "Maximum: -x² - y²"),
            (sx**2 - sy**2, "Saddle: x² - y²")]
for index, (values, title) in enumerate(examples, start=1):
    ax = fig.add_subplot(1, 3, index, projection="3d")
    ax.plot_surface(sx, sy, values, cmap="coolwarm", alpha=0.85,
                    vmin=-4.5, vmax=4.5)
    ax.scatter([0], [0], [0], color="black", s=25)
    ax.set(xlabel="x", ylabel="y", zlabel="f", title=title, zlim=(-4.5, 4.5))
    ax.view_init(elev=25, azim=-55)
fig.tight_layout()
plt.show()
1.5. \(\clubsuit\) 計算例: 線形回帰の勾配とヘッセ行列#
冒頭の線形回帰に戻り、ここまでの微分を実際に計算しよう。 \(N\geq1\)個のデータ\((x_i,y_i)\)は固定し、パラメータ\(\boldsymbol{\theta}=(a,b)^T\)だけを変数とする。 目的関数と残差を
と書く。残差の符号は冒頭と逆だが、二乗するため目的関数は同じである。 \(\partial r_i/\partial a=x_i\)、\(\partial r_i/\partial b=1\)なので、連鎖律より
したがって、勾配とヘッセ行列は
となる。このヘッセ行列はパラメータ\((a,b)\)に依存しない。 任意の変位\(\Delta\boldsymbol{\theta}=(\Delta a,\Delta b)^T\)に対して、
なので、\(\boldsymbol{H}_f\)は半正定値である。 さらに、この目的関数は二次関数なので二次のテイラー展開の誤差は厳密に0となる。 停留点\(\boldsymbol{\theta}_*\)では、任意の変位に対して
である。この不等式は小さな変位だけでなく、任意の\(\Delta\boldsymbol{\theta}\)に対して成り立つ。 つまり、どのパラメータと比較しても\(f(\boldsymbol{\theta}_*)\)より小さい値にはならないので、この停留点は大域的な最小点である。
注意: 一般の関数では局所的な情報と大域的な最適性を区別する
一般の関数では、上の結論をそのまま使うことはできない。
勾配がゼロであることは停留点の条件であり、最小点であることを保証しない。最大点や鞍点の場合もある。
2階連続微分可能な関数の停留点でヘッセ行列が正定値なら、狭義の局所最小点とはいえる。しかし、離れた場所にさらに小さい関数値がある可能性は残る。
その点のヘッセ行列が半正定値でゼロ固有値を含む場合は、局所最小点かどうかさえ二次の情報だけでは判定できない。
例えば\(f(x)=x^2-x^4\)では、\(f'(0)=0\)かつ\(f''(0)=2>0\)なので原点は局所最小点である。 しかし\(f(2)=-12<f(0)=0\)であり、大域的な最小点ではない。
一般の関数の二次のテイラー展開は、その点の近くで成り立つ近似である。 今回の線形回帰では、目的関数が二次関数なので展開の誤差が厳密に0となり、しかも二次の項が任意の変位について非負になる。 この二つの性質によって、大域的な最小点であることまで確認できる。
1.5.1. 解が一意に決まる条件#
\(x_i\)に少なくとも二つの異なる値があれば、 すべての\(i\)で\(x_i\Delta a+\Delta b=0\)となるのは\(\Delta a=\Delta b=0\)の場合だけである。 このときヘッセ行列は正定値であり、最小点は一意に決まる。
一方、すべての入力が\(x_i=c\)なら、予測値はすべて\(ac+b\)となり、 データから区別できるのはこの組合せだけである。 \(\bar y=\frac1N\sum_i y_i\)とすると、
なので、\(ac+b=\bar y\)を満たすすべての\((a,b)\)が最小点となる。 変位\((\Delta a,\Delta b)=(t,-ct)\)に沿って予測値も目的関数も変わらず、この方向がヘッセ行列のゼロ固有値に対応する。
計画行列\(\mathbf{X}\)の各行を\((x_i,1)\)とすれば、上の結果は \(\nabla f=\frac2N\mathbf{X}^T(\mathbf{X}\boldsymbol{\theta}-\mathbf{y})\)、 \(\boldsymbol{H}_f=\frac2N\mathbf{X}^T\mathbf{X}\)とまとめられる。 解の行列表現と一般の基底関数への拡張は線形回帰の章で扱う。
1.5.2. 中心差分による勾配の検算#
手計算やコードで求めた勾配は、各パラメータを少しだけ変えて検算できる。 \(\mathbf{e}_j\)を\(j\)番目の成分だけが1の単位ベクトルとすると、中心差分は
である。十分滑らかな一般の関数では打切り誤差は\(O(h^2)\)だが、\(h\)を小さくしすぎると丸め誤差の影響が大きくなる。 今回の二次関数では打切り誤差は厳密に0なので、数値的なずれは主に浮動小数点演算によるものである。
問題
\(f(x,y)=x^2+2y^2\)の点\((1,1)\)において、\(\mathbf{v}=(1,1)^T/\sqrt2\)方向の方向微分を求めよ。ま1た、単位長さあたりの減少率が最も大きい方向を求めよ。
\(f(x,y)=x^2+xy+2y^2\)について、点\((1,0)\)で二次までのテイラー展開を求め、元の関数と厳密に一致することを確認せよ。
1.6. 条件つき最適化#
機械学習モデルのような特定のモデルでデータの説明を試みる場合、モデルのパラメータや変数に対して制約条件が課されることがある。 こうした場合、制約条件を満たしつつ目的関数を最小化する必要がある。 そのような問題を条件つき最適化問題と呼ぶが、中でも非常によく用いられる手法が ラグランジュ未定乗数法 (Lagrange multipliers) である。
上の式の意味するところは、\(m\)個の制約条件\(g_i(\mathbf{x}) = 0\)を満たしつつ、目的関数\(f(\mathbf{x})\)を最小化せよ、ということである。 制約のない微分可能な関数では、定義域の内部の極値候補を\(\nabla f(\mathbf{x})=0\)から探せるが、それだけで最小点と判定できるわけではない。 等式制約がある場合は、ラグランジュ関数を導入して次の条件を考える。
\(f,g_1,\ldots,g_m\)が考える点の近傍で連続微分可能であり、制約を満たす局所最適点\(\mathbf{x}_*\)で 制約勾配\(\nabla g_1(\mathbf{x}_*),\ldots,\nabla g_m(\mathbf{x}_*)\)が一次独立ならば、 上の条件を満たす乗数\(\boldsymbol{\lambda}\)が存在する。 これは局所最適点の必要条件であり、方程式の解が最小点であることを保証する十分条件ではない。 得られた候補について、制約上での関数値の比較や二次の変化などを調べ、最適性を確認する必要がある。 制約勾配が一次独立でない点や、別途定義域の境界がある場合の境界上の候補は、別に調べる必要がある。
幾何学的には、制約を保つ接線方向\(\mathbf{v}\)は\(\nabla g_i^T\mathbf{v}=0\)を満たす。 正則な制約上の局所最適点ではその方向の変化率\(\nabla f^T\mathbf{v}\)も0となるため、 目的関数の勾配は制約勾配の線形結合\(\nabla f=-\sum_i\lambda_i\nabla g_i\)で表される。 制約が一つなら、目的関数と制約の勾配が平行になる(目的関数の勾配がゼロの場合も含む)。
練習問題
制約条件\(x+y=1\)のもとで、関数\(f(x,y) = x^2 + y^2\)を最小化せよ。
この方程式から、候補\(x=y=\frac12\)と\(\lambda=-1\)を得る。 ここで制約勾配は\((1,1)^T\ne\mathbf0\)なので、上の必要条件を適用できる。 最小点であることは、制約\(y=1-x\)を目的関数に代入して
と書けば確認できる。等号は\(x=y=\frac12\)のときだけ成り立つので、これが制約上の一意な大域的最小点である。
問題の式をみると、\(f(x,y)\)は\(x,y\)の二乗和でありこれを\(r^2\)とおけば、原点を中心とする半径\(r\)の円上の点を表せる。 一方で、制約条件\(x+y=1\)は、\(x\)軸との交点\((1,0)\)と\(y\)軸との交点\((0,1)\)を通る直線を表す。 したがって今の問題は、原点を中心とする半径\(r\)の円が、直線\(x+y=1\)に接するような\(r\)と接点を求める問題である事がわかる。
簡単な問題の場合は、こうした幾何学的な解釈を行うことで、最適解を直感的に理解できることがあるが、より複雑な問題の場合は、ラグランジュ未定乗数法のような一般的な手法を用いるのが良いだろう。
問題
表面積が一定である直方体のうち、体積が最大となるものが立方体であることをラグランジュ未定乗数法を用いて示せ。
1.7. 学習の振り返りのためのチェックリスト#
▢ 一変数関数の微分とテイラー展開の基本を説明できる
▢ 偏微分・勾配の意味と、勾配降下法との関係を説明できる
▢ ヤコビ行列と連鎖律を用いて、合成関数を微分できる
▢ 多変数のテイラー展開とヘッセ行列を用いた極値判定を説明できる
▢ ラグランジュ未定乗数法で条件つき最適化の候補を求め、最適性を確認できる