
5. 確率と疑似乱数#
この章では、確率と疑似乱数について扱う。
import random
import numpy as np
from matplotlib import pyplot as plt
5.1. 疑似乱数について#
コンピュータで何かの処理を実現したいときや、自然科学や統計学などで様々なことをシミュレーションしたいとき、[確率的な事象]を考えたくなることがよくある。 たとえば人◯ゲームや◯鉄のようなゲームを作るときにもサイコロの出目が必要になるし、技が急所に当たる確率や色違いのポ◯モンが出現する確率などを設定しなければならない.
理想的なサイコロならば、1から6の目が出る確率は等しく1/6である。このような確率的な振る舞いをプログラムで扱うために、ここでは決まった手順で乱数列(用途に対して十分ランダムだとみなせる数の並び)を生成する。物理現象を利用した乱数生成もあるが、この章では扱わない。
真の意味での乱数と区別する意味で、我々が普段ゲームなどで扱う乱数は疑似乱数と呼ばれるべきものだが、以下ではめんどくさいので、単に乱数と呼ぶことにする。
詳細には立ち入らないが、乱数を生成する方法はいくつもあり、それ自体が研究の対象になっている。 現在もよく使われている代表的な手法はメルセンヌツイスタと呼ばれる方法で、多くのプログラミング言語でも採用されている。
またモンテカルロ法と検索すると(主に学術的な分野で)乱数がどのように活用されているか、雰囲気を味わうことができる。 ちなみに、モンテカルロはカジノで有名なモナコの地名Monte Carloに由来している。
5.2. Pythonでの乱数生成#
Pythonではrandomモジュールを使えば簡単に乱数を使用することができる。
random.randint(1, 6)
3
のようにrandom.randint(最小値,最大値)とすると指定した閉区間の整数値をランダムに生成することができる。
上のコードセルを繰り返し実行すると様々な目が出ること(同じ目が続くこともある)も確かめよう。
今の場合、最小値に1、最大値に6を採用したことで、この乱数をサイコロの出目とみなすことができる。
rangeなどと違い、最大値の6も含まれていることに注意! 紛らわしい...。
100個のサイコロの出目を保持しておきたければ、2章で学習したリスト内包表記を用いて
a = [random.randint(1, 6) for i in range(100)]
print(a)
[1, 3, 3, 2, 4, 1, 3, 4, 1, 6, 2, 3, 3, 2, 5, 2, 6, 1, 4, 6, 1, 6, 4, 6, 4, 2, 2, 5, 4, 4, 4, 3, 5, 2, 5, 1, 3, 3, 1, 4, 3, 1, 5, 1, 6, 3, 4, 5, 4, 1, 5, 5, 3, 1, 5, 6, 2, 3, 6, 5, 2, 4, 5, 2, 4, 2, 5, 4, 5, 3, 4, 5, 6, 6, 1, 2, 3, 2, 3, 6, 2, 4, 6, 2, 1, 6, 2, 4, 1, 1, 5, 2, 5, 2, 1, 4, 5, 4, 6, 2]
などとすればよい。\(10^p\)回 (\(p=1,2,...,6\))サイコロを振った場合の出目をそれぞれヒストグラムにしてみると...
# サンプルの数を指定し、それぞれのサイコロの出目を用意して入れ子のリストにする
ps = range(1, 7)  #  10^p 次数(power)
Ns = [10**p for p in ps]
results = [[random.randint(1, 6) for i in range(N)] for N in Ns]

# ヒストグラムのビンの始点,終点,ステップを定義
tbin = np.arange(0.5, 7.5, 1)

# 作図 (axを用いて、一つのグラフに6つの領域を用意して作画する)
# add_subplot(n,m,i)で、縦n個, 横m個の領域を用意した場合の i番目(列方向,行方向の順番にカウントする. a行b列の小領域は i = (a-1)*m + b)
fig = plt.figure(figsize=(20, 5))
axs = [
    fig.add_subplot(2, 3, i) for i in range(1, len(results) + 1)
]  # データの個数に応じて小領域の数を自動で変えたい場合は"(2,3"部分の工夫が必要。
for i in range(len(axs)):
    axs[i].set_xlabel("Roll")
    axs[i].set_ylabel("Count")
    axs[i].set_title("$n=10^" + str(ps[i]) + "$")  # $で囲むとlatex表記を用いることができる
    axs[i].hist(results[i], bins=tbin, rwidth=0.5)  # ヒストグラムを描画
# グラフ間の縦の間隔hspaceをdefault値(0.3)から少し大きく調整
plt.subplots_adjust(hspace=0.45)
plt.show()
plt.close()
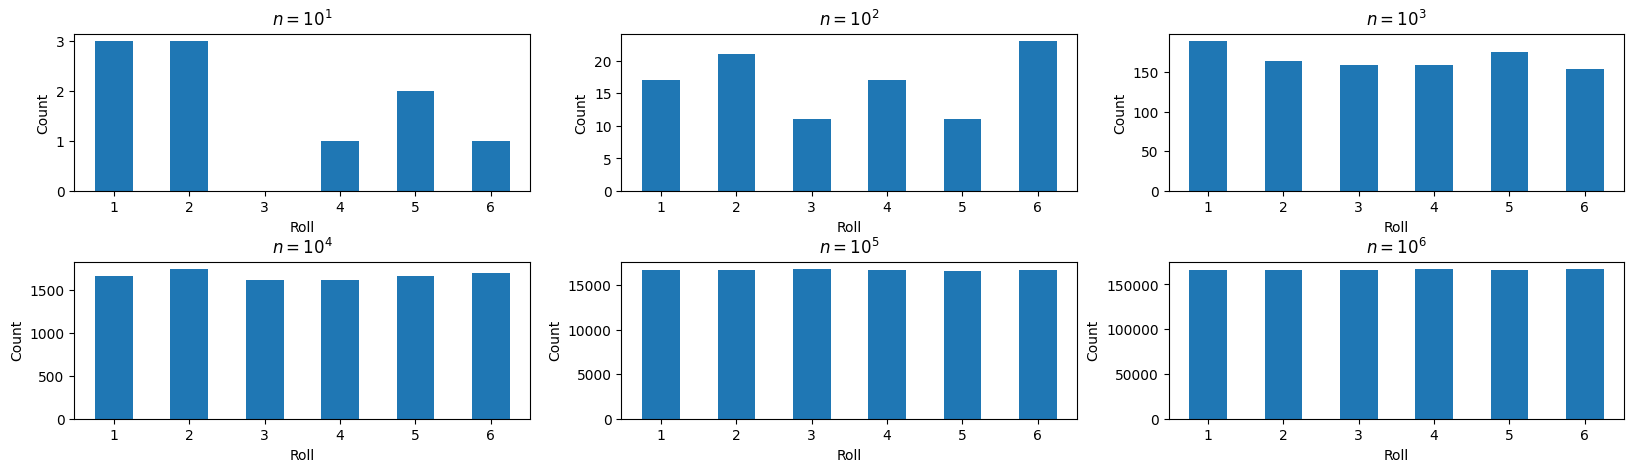
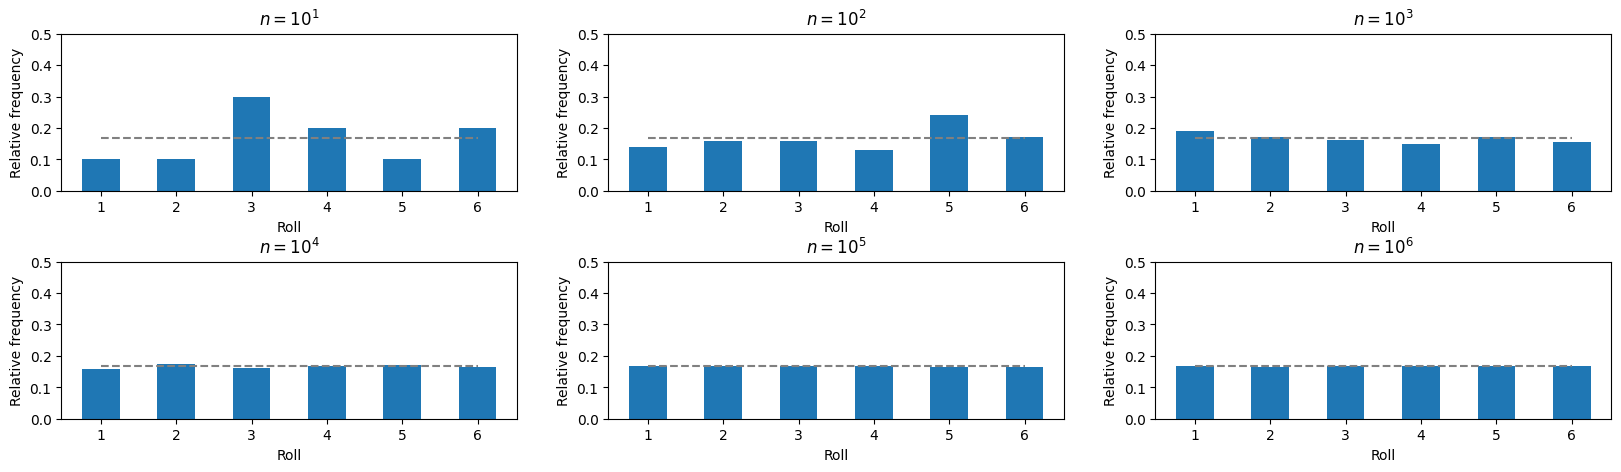
1-6の出る目の頻度が確率から期待される振る舞いに漸近していく事がわかる. c.f. 大数の法則
今のようにサンプル数が大きく異なるヒストグラムを比較する場合、相対的な頻度に直し、縦軸の範囲も揃えると比較しやすい。
以下では density=True を指定する。これは、各ビンの「高さ × ビン幅」の合計が1になるように規格化するオプションである。今はビン幅が1なので、棒の高さがその目の出た割合と一致する。
ビン幅が1以外なら、棒の高さは割合をビン幅で割った確率密度になる。weights に各データの重み 1/N を与えて割合を求める方法とは、この点が違う。
ps = [1, 2, 3, 4, 5, 6]
Ns = [10**p for p in ps]
results = [[random.randint(1, 6) for i in range(N)] for N in Ns]
tbin = np.arange(0.5, 7.5, 1)
fig = plt.figure(figsize=(20, 5))
axs = [fig.add_subplot(2, 3, i) for i in range(1, len(results) + 1)]
for i in range(len(axs)):
    axs[i].set_xlabel("Roll")
    axs[i].set_ylabel("Relative frequency")
    axs[i].set_ylim(0, 0.5)
    axs[i].set_title("$n=10^" + str(ps[i]) + "$")
    axs[i].hist(results[i], bins=tbin, rwidth=0.5, density=True)  # density=Trueオプションを指定
    axs[i].plot([1, 6], [1 / 6, 1 / 6], color="gray", linestyle="dashed")  # ココを追加した
plt.subplots_adjust(hspace=0.45)
plt.show()
plt.close()
関連する注: NumPy
NumPyにも乱数生成機能があるが、random モジュールとそのまま置き換えられるわけではない。たとえば、random.randint(1, 6) は6を含むが、np.random.randint(1, 6) は6を含まない。紛らわしいので実際に確かめよう。
この資料では既存の例に合わせて np.random の関数を使う。新しくコードを書く場合には、rng = np.random.default_rng() として生成器を用意する方法もある。詳しくはNumPy公式ドキュメントを参照。
# numpyの中にあるrandintで(1,6)を指定し、サンプルをたくさん(10^6)作ってみる。
# それをsetで重複を取り除いて、現れた数を見てみると...6がない。

Nsample = 10**6
print("randomの(random.randintを使う)場合 =>", set([random.randint(1, 6) for i in range(Nsample)]))
print("numpyの(np.random.randintを使う)場合 =>", set(np.random.randint(1, 6, Nsample)))
randomの(random.randintを使う)場合 => {1, 2, 3, 4, 5, 6}
numpyの(np.random.randintを使う)場合 => {1, 2, 3, 4, 5}
以下では、randomモジュールのよく使う(?)機能をいくつか紹介する.
5.3. 無作為抽出#
リストやrangeなどからランダムに要素を選びたいときにはrandom.choiceが便利だ。たとえば、 出席番号のリストからランダムに選ぶといった状況をイメージしよう。
ループに入れて5回くらい実行してみよう。
for i in range(5):
    ## 引数(リスト)からランダムに要素を抽出する
    a = random.choice([1, 3, 5, 6])

    ## 引数(range,0から99)からランダムに要素を抽出する
    b = random.choice(range(100))

    ## 引数(リスト)からランダムに要素を抽出する
    c = random.choice(["日本", "アメリカ", "中国"])

    print("a=>", a, "\tb=>", b, "\tc=>", c)
a=> 6 	b=> 11 	c=> 中国
a=> 5 	b=> 92 	c=> 中国
a=> 3 	b=> 32 	c=> 中国
a=> 3 	b=> 50 	c=> 日本
a=> 5 	b=> 29 	c=> アメリカ
「0から99までの100個の整数値から重複を許さずに10個選びたい」といった場合は、numpy.randomのchoice関数のほうが便利だ。
import numpy as np

np.random.choice(
    range(100), 10, replace=False
)  # replace = True/Falseで重複を認めるかどうかを指定できる
array([60, 5, 73, 72, 26, 11, 63, 97, 40, 21])
上の関数のreplace=True or replace=Falseを変えて何回か実行してみて、抽出された数に重複があるかどうかを確かめてみよう。
ちなみに選んだものをソートしたければ組み込み関数sortedなどを使うと良い:
sorted_array = sorted(np.random.choice(range(100), 10, replace=False))

print(sorted_array)
[1, 21, 54, 64, 68, 73, 79, 86, 92, 98]
ソートされたindexを生成することも出来る
target = np.random.choice(range(100), 10, replace=False)
idx_sort = np.argsort(target)
print("target:", target)
print("昇順に対応したインデックス:", idx_sort)
print("idx_sortを用いたソート済の配列", [target[idx] for idx in idx_sort])
target: [56 37 72  0 62 87 22 99 40 81]
昇順に対応したインデックス: [3 6 1 8 0 4 2 9 5 7]
idx_sortを用いたソート済の配列 [0, 22, 37, 40, 56, 62, 72, 81, 87, 99]
5.4. 一様分布からの乱数生成#
上記のような離散的な乱数とは異なり、連続的な数について乱数が必要になる場合もある。
その一つの例である一様乱数は、ある有限区間で確率密度が一定となる分布に従う乱数で、
random.uniform()関数を使えば、指定した区間での一様乱数を生成することができる。
# [1.0, 10.0)または[1.0, 10.0]からの一様乱数
# randomモジュールでは半開区間/閉区間どちらになるかはrounding(丸め操作)に依存するみたい
random.uniform(1.0, 10.0)
4.530719557916074
xとyの値を[-1,1]の範囲でランダムに10000サンプル生成してplotしてみよう
num = 10000
xs = [random.uniform(-1, 1) for i in range(num)]
ys = [random.uniform(-1, 1) for i in range(num)]

# 3つの領域に、散布図・xのヒストグラム・yのヒストグラムを描く
fig = plt.figure(figsize=(12, 3))
axs = [fig.add_subplot(131), fig.add_subplot(132), fig.add_subplot(133)]
axs[0].scatter(xs, ys, color="green", s=0.5, alpha=0.4)
axs[0].set_xlabel("x")
axs[0].set_ylabel("y")
axs[1].set_xlabel("x")
axs[1].set_ylabel("count")
axs[2].set_xlabel("y")
axs[2].set_ylabel("count")
axs[1].hist(xs, bins=50, ec="w")  # xのヒストグラム (binの数50はいい加減に選んだ)
axs[2].hist(ys, bins=50, ec="w")  # yのヒストグラム 同じく
plt.show()
plt.close()
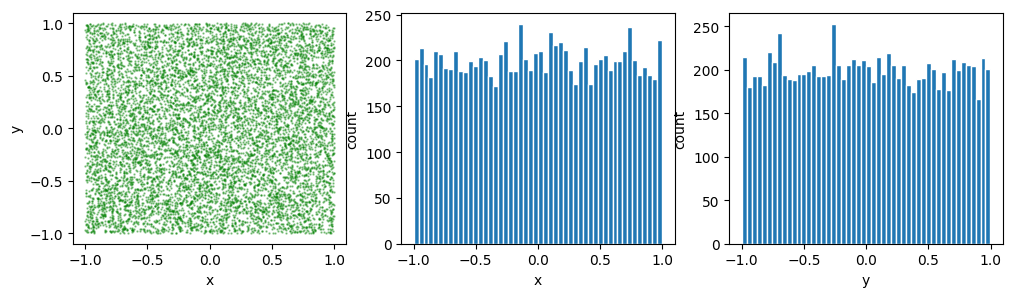
\(\clubsuit\) 散布図とヒストグラムをまとめて描く
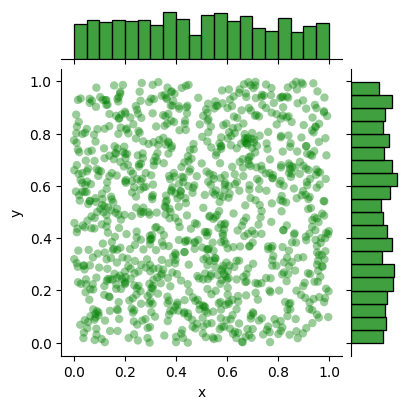
もうちょっとかっこよく描きたければseabornというモジュールのjointplotを用いると良い。
import seaborn as sns

num_samples = 10**3
xs = np.random.uniform(0, 1, num_samples)
ys = np.random.uniform(0, 1, num_samples)

h = sns.jointplot(
    x=xs, y=ys, color="green", alpha=0.4, height=4, ec="None", marginal_kws=dict(bins=20)
)
h.set_axis_labels("x", "y")
plt.show()
5.4.1. じゃんけん関数#
乱数を使ってじゃんけんをする関数を作ってみよう。
def Janken():
    r = ["グー", "チョキ", "パー"]
    return r[random.randint(0, 2)]
Janken()
'チョキ'
# あるいは、手を0,1,2として計算する関数とじゃんけんの手に反映させる部分を分けても良い


def Janken():
    return random.randint(0, 2)


RPS = ["グー", "チョキ", "パー"]  # integer to Rock-Paper-Scissors

# 5回手を表示させてみる
for i in range(5):
    print(RPS[Janken()])
グー
グー
グー
チョキ
パー
今の場合Janken()は、単に1/3の確率で手を選ぶ関数だが、これを拡張していけば確率を1/3から変動させたじゃんけんの実装も可能となる。
2つの手の確率を指定すれば、残りも一意に決まるので、たとえば、0から1の区間から一様乱数を発生させて、ある領域に含まれたらグー、ある領域に含まれたらチョキ、残りはパー、とすれば良い。
def my_RPS(p_rock, p_scissors):
    if not (0 <= p_rock <= 1 and 0 <= p_scissors <= 1 and p_rock + p_scissors <= 1):
        raise ValueError("確率は0以上、合計は1以下にしてください。")
    r = random.random()  # 0以上1未満
    if r < p_rock:
        return 0
    elif r < p_rock + p_scissors:
        return 1
    else:
        return 2


# 20%でグー(0)、30%でチョキ(1)、50%でパー(2)を出す人の手を10^5回集計してみる
data = [my_RPS(0.2, 0.3) for _ in range(10**5)]
print("グーの割合 =>", data.count(0) / len(data))
print("チョキの割合 =>", data.count(1) / len(data))
print("パーの割合 =>", data.count(2) / len(data))
グーの割合 => 0.19855
チョキの割合 => 0.30288
パーの割合 => 0.49857
じゃんけん関数を工夫したり、サザ◯さんやドラ◯もんのじゃんけんのパターンを解析することで、ドラ◯もんやサザ◯さんを倒す関数を作ってみるのも面白そうだ。
5.4.2. \(\clubsuit\)一様乱数を用いた円周率の計算#
プログラミングでド定番の、乱数を使って円周率を求める方法もPythonならサクッと実装することができる。
def pi_approx(p):
    num = 10**p
    x = np.random.rand(num)
    y = np.random.rand(num)
    return 4 * np.sum(x * x + y * y < 1.0) / num


pi_approx(5)
3.15188
このコードでは、\(10^p\)組の一様乱数を発生させて、
四分円の内部に入った個数を全体の数(num)で割り、4倍することで円周率を近似している。
(1/4円の面積は\(\pi\)/4で、正方形の面積が1であることを使う)
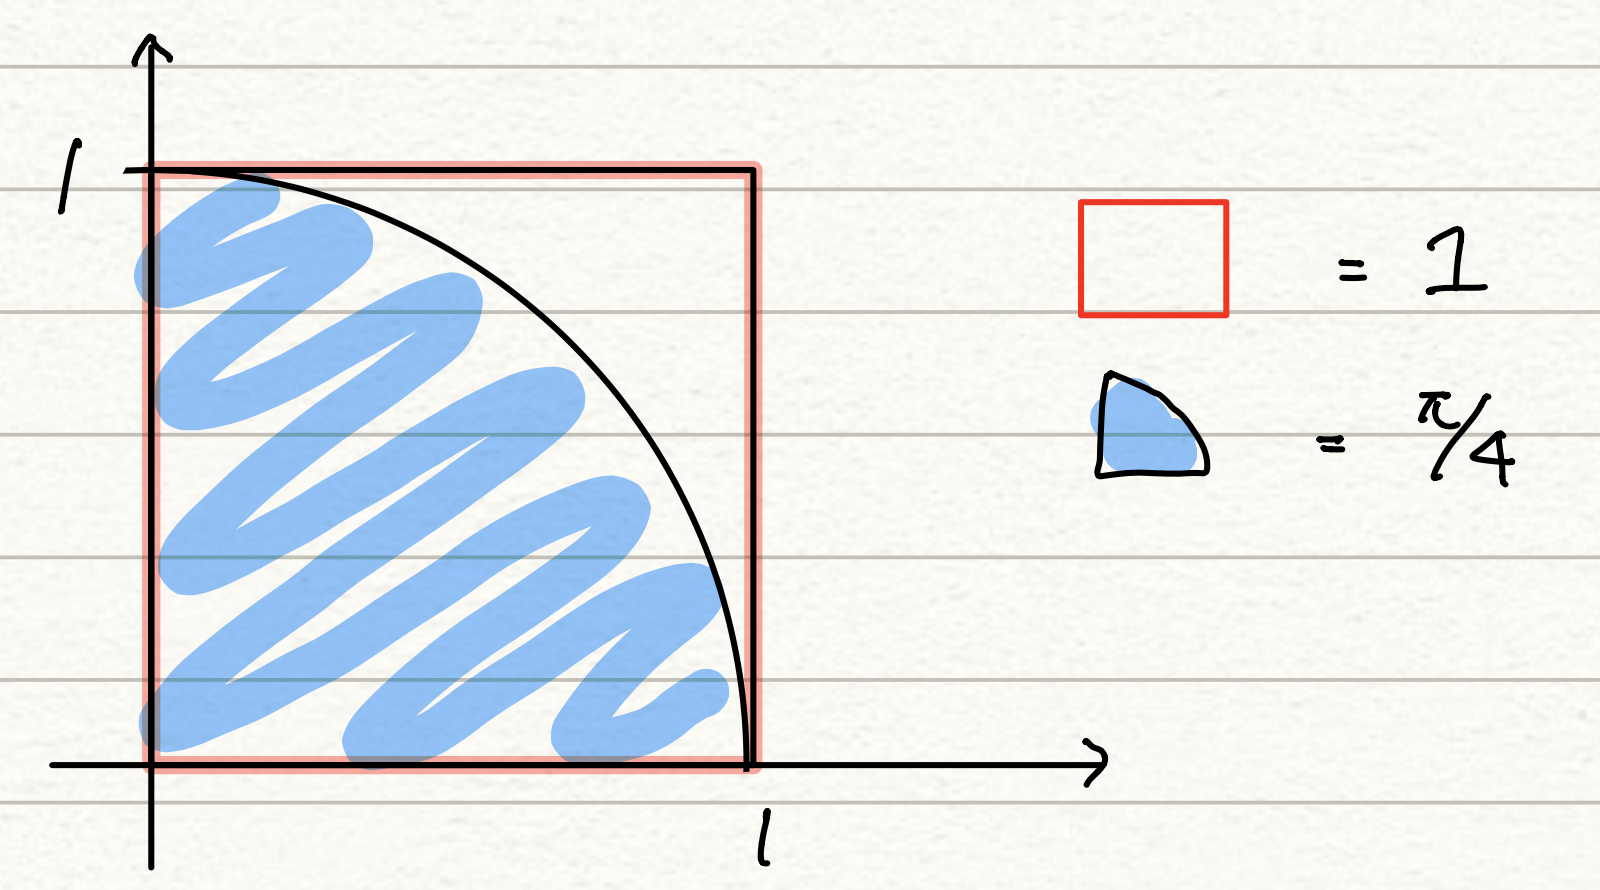
サンプル数を増やしながら、円周率との差を見てみよう。誤差は毎回必ず小さくなるわけではないが、多数の試行では典型的な誤差が小さくなる。
np.random.seed(1234)
estimates = []
for p in range(1, 8):  # サンプル数を一桁ずつ増やす
    tmp = pi_approx(p)
    estimates += [[10**p, np.log10(abs(tmp - np.pi))]]
    print("p=", p, "\t", "pi_approx", tmp, "log10(abs(diff))", np.log10(abs(tmp - np.pi)))
estimates = np.array(estimates).T

fig = plt.figure(figsize=(10, 3))
ax = fig.add_subplot(111)
ax.set_xlabel("Sample number")
ax.set_ylabel("Diff. in log10")
ax.set_xscale("log")
ax.plot(estimates[0], estimates[1], marker="o")
plt.show()
plt.close()
p= 1 	 pi_approx 2.8 log10(abs(diff)) -0.46649147797051027
p= 2 	 pi_approx 2.92 log10(abs(diff)) -0.6544446417698763
p= 3 	 pi_approx 3.1 log10(abs(diff)) -1.3809833709877704
p= 4 	 pi_approx 3.1316 log10(abs(diff)) -2.000319167792708
p= 5 	 pi_approx 3.1458 log10(abs(diff)) -2.3759917290460537
p= 6 	 pi_approx 3.140808 log10(abs(diff)) -3.105322034013356
p= 7 	 pi_approx 3.1410364 log10(abs(diff)) -3.254727173274235
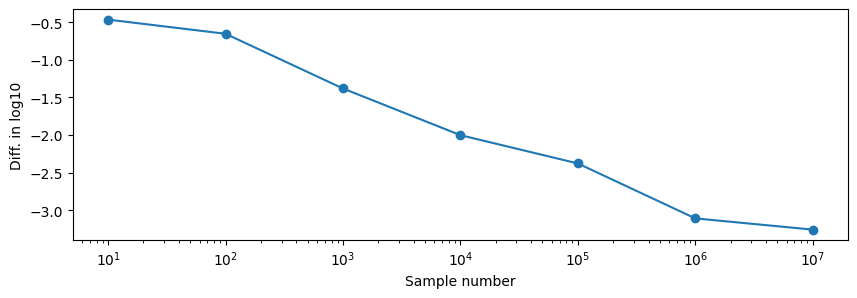
あまり効率は良くない。サンプル数を10倍にしても、精度が10倍になるわけではないからだ。この方法の誤差の典型的な大きさは、サンプル数の平方根に反比例する。
上では \(10^7\) サンプルまでに留めた。このコードは x と y だけでも1要素あたり合計16バイトを使い、計算途中の配列にもメモリが必要になる。\(10^8\) なら x と y だけで約1.5 GiB。むやみに \(p\) を増やすと、メモリ不足でランタイムが止まることもある。
import numpy as np


def pi_approx_mem(p):
    num = 10**p
    x = np.random.rand(num)
    y = np.random.rand(num)
    print(
        "p=" + str(p) + "のとき => ndarrayのサイズは~",
        str("%5.2f" % ((x.nbytes + y.nbytes) / 1024**3)),
        " GiB程度(xとyのみ)",
    )
    return 4 * np.sum(x * x + y * y < 1.0) / num


pi_approx_mem(7)
pi_approx_mem(8)
p=7のとき => ndarrayのサイズは~ 0.15 GiB程度(xとyのみ)
p=8のとき => ndarrayのサイズは~ 1.49 GiB程度(xとyのみ)
3.14139812
5.5. 正規分布からの乱数生成#
正規分布は多くの特徴的な性質を有している。
それらは後述するとして...正規分布に従う乱数を生成するには
random.gauss()もしくはrandom.normalvariate() を用いればよい.
※両者は基本的に同じだが、前者のほうが高速らしい
a = random.gauss(0.0, 1.0) # 平均0.0,標準偏差1.0の正規分布からの乱数生成
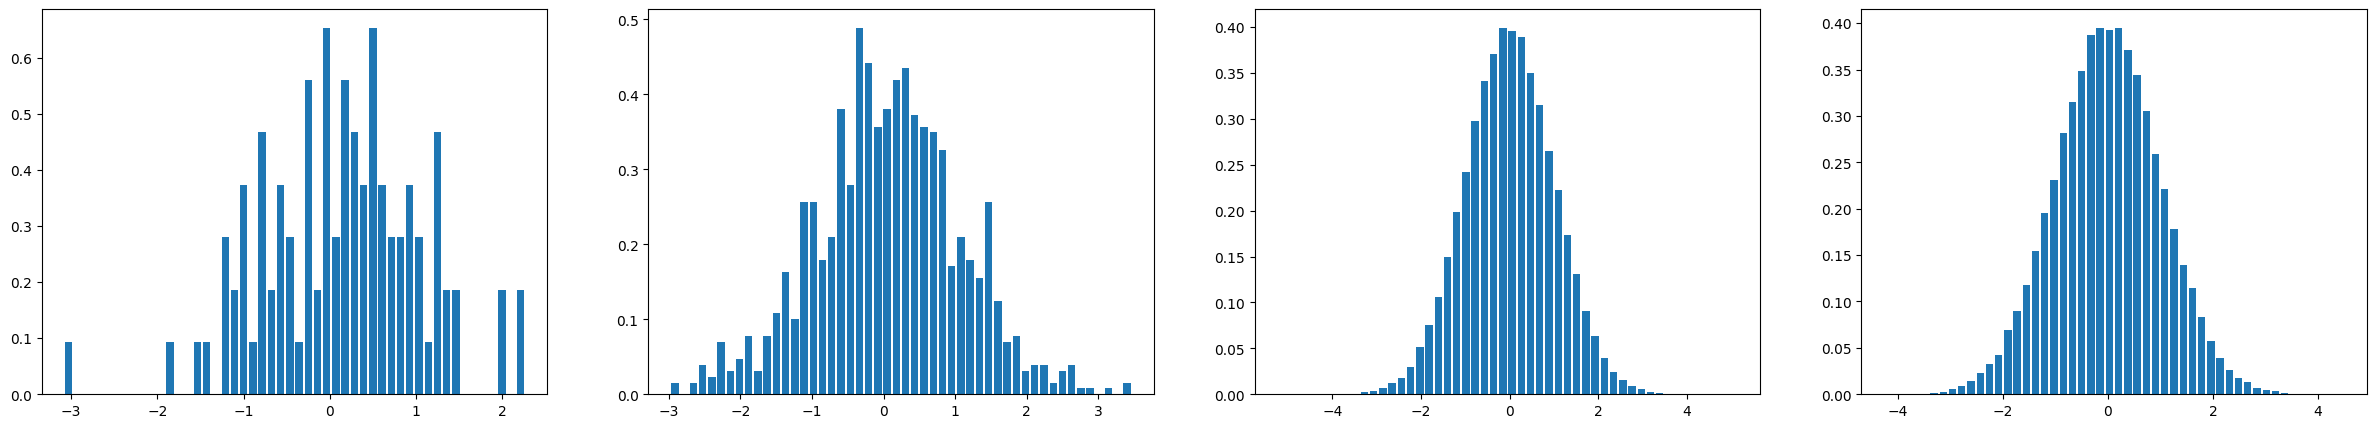
サンプル数を何通りか作って、正規分布になっているかチェック
Na = 100
Nb = 1000
Nc = 100000
a = [random.gauss(0.0, 1.0) for i in range(Na)]
b = [random.gauss(0.0, 1.0) for i in range(Nb)]
c = [random.gauss(0.0, 1.0) for i in range(Nc)]
c2 = [random.normalvariate(0.0, 1.0) for i in range(Nc)]  # 一応normalvariateも使ってみる

fig = plt.figure(figsize=(30, 5))
axs = [fig.add_subplot(141), fig.add_subplot(142), fig.add_subplot(143), fig.add_subplot(144)]
axs[0].hist(a, bins=50, density=True, rwidth=0.8)
axs[1].hist(b, bins=50, density=True, rwidth=0.8)
axs[2].hist(c, bins=50, density=True, rwidth=0.8)
axs[3].hist(c2, bins=50, density=True, rwidth=0.8)
plt.show()
plt.close()

# 平均と標準偏差も計算してみる
print("mu,sigma a:", np.mean(a), np.std(a))
print("mu,sigma b:", np.mean(b), np.std(b))
print("mu,sigma c:", np.mean(c), np.std(c))
print("mu,sigma c2:", np.mean(c2), np.std(c2))
mu,sigma a: 0.13198598130501019 0.9139297415550447
mu,sigma b: 0.058183625551653455 1.011385064984811
mu,sigma c: 0.003166959509035125 0.9981422113610158
mu,sigma c2: -0.0016625538329764766 1.0012023602903648
サンプル数が増えるにつれて、ヒストグラムが元の正規分布の形に近づく様子が見られる。
余談: 正規乱数をどう生成するかについては、AI・機械学習論1の資料でも少し触れているので、興味があればそちらも参照してみてほしい。
5.6. 乱数の種(seed)の固定#
これまでのプログラムでは、実行の度に答えが変わった。
擬似的にでもランダム性が担保されているというのは便利だが、実際にプログラミングで乱数を使って何かの作業を実装したいときは、何か直感と反するような振る舞いをコードが示した際、それがランダム性からくる偶然の挙動なのか、コードにバグがあるせいなのかを切り分けたい状況もある。
そんなときには、random.seed(適当な整数値) を使って乱数の"種"を指定することで、再現性のあるコードにすることができる。たとえばサイコロの例でいうと
[random.randint(1, 6) for i in range(10)]
[5, 3, 2, 4, 5, 3, 2, 2, 5, 3]
は実行する度に答えが変わるが
random.seed(1234)
[random.randint(1, 6) for i in range(10)]
[4, 1, 1, 1, 5, 1, 6, 6, 1, 1]
は何度実行しても同じ答えになる。これは、乱数の生成前に"種"を指定しているため。
イメージとしては、「同じ手順で乱数列を作るために、生成器の初期状態を指定する」のが、このrandom.seed関数(細かいことを無視すると、だいたいこんなイメージ).
注意点としては、たとえばループを回して乱数を生成するときに
for i in range(10):
    random.seed(1)
    print( random.uniform(0,1) )
などとすると、乱数を生成する前に毎回seedが1に固定されるので、毎回同じ乱数になってしまう。
余談
古いゲームだと、起動してからの経過時間が乱数の種になっていることが多いようで、このパターンを調べることができれば、原理的には(1/30~1/60秒程度の正確な入力が可能なら)望むようにゲームをスイスイ攻略することもできる。
これを利用して攻略を進めたり、コンピュータにゲームの操作をやらせて、メタル◯ライムに会心の一撃を食らわせてレベルアップしまくる動画などが昔流行った(今も時々ある)。
random.seed と np.random.seed は別々の生成器を設定する。片方を固定しても、もう片方は固定されない。ライブラリの版や乱数を呼び出す順番も、結果に影響することがある。
5.7. 正規分布に関して#
この授業は確率・統計の授業ではないので、深入りはしないが、正規分布(ガウス分布,ガウシアン)に少し触れておく。 (変数が1次元の場合の正規分布に限り、厳密性は少々犠牲にして説明する)
正規分布が重要である理由はいくつかあるが、
世の中に(近似的に)正規分布に従う確率変数がたくさんある
"性質が良い"(扱いやすい)確率分布である
の2点が代表的な理由だろうか。 たとえば、同年代・同性の人の身長などは、正規分布で近似して扱うことがある。ただし、体重や試験の得点まで自動的に正規分布とみなしてよいわけではない。 (もちろん例外はあって、左右非対称であったり二山型の分布になっていることもある)
ある変数\(x\)が中心\(\mu\)、標準偏差\(\sigma>0\)の正規分布に従うとき、\(x\)の確率密度関数\(f(x)\)は、以下の様に表現される。
\(f(x) = \frac{1}{\sqrt{2\pi \sigma^2}}\exp{(-\frac{(x-\mu)^2}{2\sigma^2})}\)
一見、難しそうな式だが、重要なのは \(x=\mu\)で最大値となり、\(x\)が\(\mu\)から離れていくとどんどん値が小さくなる関数 になっているという点だ。
関数の形を見てなんとなく「平均値の周りに広がった分布になっているんだな」と理解できればこの授業では問題ない。
実際に、上の\(x\)についての関数\(f(x)\)の値を、\(\mu\)や\(\sigma\)を変えながらplotしてみると...
def gaussian(mu, sigma, xr):
    return np.exp(-((xr - mu) ** 2) / (2.0 * sigma**2)) / np.sqrt(2.0 * np.pi * sigma**2)


xr = np.arange(-6.0, 6.0, 0.01)
yr1 = gaussian(0.0, 1.0, xr)
yr2 = gaussian(1.0, 2.0, xr)
yr3 = gaussian(-2.0, 0.5, xr)

fig = plt.figure(figsize=(12, 4))
plt.plot(xr, yr1, label="mu=0.0, sigma=1.0")
plt.plot(xr, yr2, label="mu=1.0, sigma=2.0")
plt.plot(xr, yr3, label="mu=-2.0, sigma=0.5")
plt.plot([-7, 7], [0, 0], color="gray", linestyle="dotted")
plt.legend()
plt.show()
plt.close()
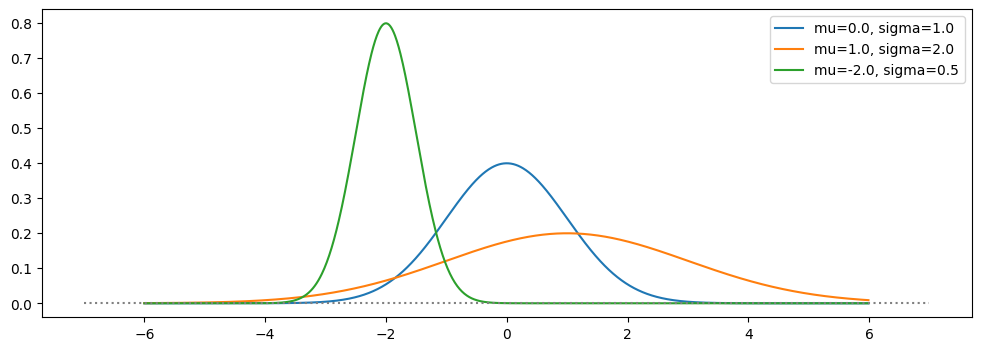
こんな感じ。このような形状の分布を示すデータ(量)が世の中には溢れている。
指数関数\(\exp\)の前についている係数\(1/\sqrt{2\pi \sigma^2}\)は、この関数をあらゆるxの値で足し上げたときに、その値が1になるようにつけてある。 つまり、x軸と関数\(f(x)\)が囲む領域の面積=xの全区間での積分\(\int^{\infty}_{-\infty}f(x) dx \)が1になる。
こうしておけばどの\(\mu,\sigma\)を持つ正規分布を考えたときにでも、
「どこからどこまでの区間の面積が全体に占める割合が何%だ」といった表現が可能になり、確率として扱いやすくなる。
この関数の不定積分は初等関数では表せないが、誤差関数という特殊関数や数値積分を使えば有限区間の積分も求められる。全実数上での積分が \(\sqrt{2\pi\sigma^2}\) になることは、ガウス積分として知られている。
以下では\(\mu=0.0\), \(\sigma=1.0\)のみを考えることにして、もう少し正規分布の特徴的な性質について見てみよう。
def gaussian(mu, sigma, xr):
    return np.exp(-((xr - mu) ** 2) / (2.0 * sigma**2)) / np.sqrt(2.0 * np.pi * sigma**2)


fig = plt.figure(figsize=(14, 4))
axs = [fig.add_subplot(131), fig.add_subplot(132), fig.add_subplot(133)]
xr = np.arange(-5.0, 5.0, 0.01)
yr = gaussian(0.0, 1.0, xr)
for i in range(3):
    axs[i].plot(xr, yr, label="mu=0.0, sigma=1.0")
    axs[i].plot([-4, 4], [0, 0], color="gray", linestyle="dotted")
x_sig1 = np.arange(-1.0, 1.0, 0.01)
x_sig2 = np.arange(-2.0, 2.0, 0.01)
x_sig3 = np.arange(-3.0, 3.0, 0.01)
axs[2].fill_between(x_sig3, 0.0 * x_sig3, gaussian(0.0, 1.0, x_sig3), color="green", alpha=0.9)
axs[1].fill_between(x_sig2, 0.0 * x_sig2, gaussian(0.0, 1.0, x_sig2), color="blue", alpha=0.9)
axs[0].fill_between(x_sig1, 0.0 * x_sig1, gaussian(0.0, 1.0, x_sig1), color="red", alpha=0.9)
plt.show()
plt.close()
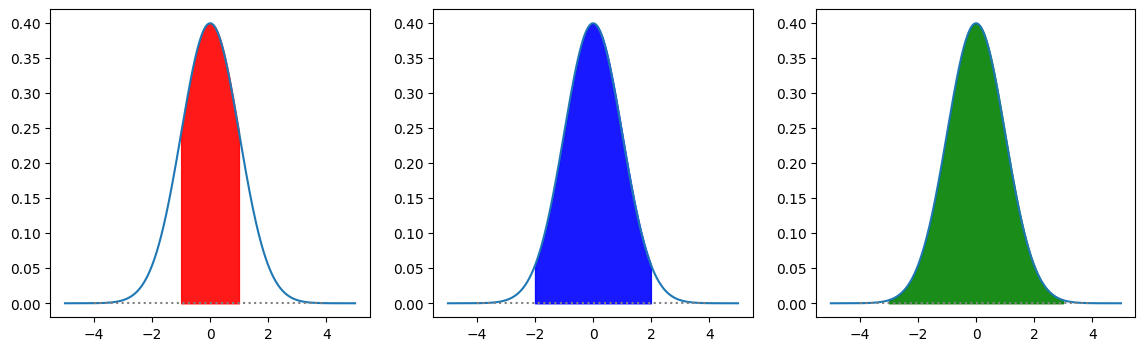
上の図では、\(\mu \pm 1\sigma\), \(\mu \pm 2\sigma\), \(\mu \pm 3\sigma\)の領域での正規分布とx軸とが囲む領域を、それぞれ赤色、青色、緑色で塗りつぶした。
これらが占める面積は、それぞれ0.6827, 0.9545,0.9973(いずれも"約")となり、それぞれ約68.27%、95.45%、99.73%を含む区間である。このことは、任意の\(\mu,\sigma\)を持つ1次元の正規分布について成立する。
正負の値をとる\(x\)(たくさんの人のなんらかのスコアとでもしよう)の分布が平均0.0,標準偏差が1.0の正規分布に従っている場合(理想的な場合)なら、全体の68%程度の人の得点は1シグマ領域(赤)、つまり-1から1までの間に分布していることを意味する。
もちろん、実際の場合、分布は真には正規分布になっていないし、有限なサンプル数を考えた場合、平均と標準偏差を計算しても1シグマの中に全体の68%が分布しているわけではない。
また、正規分布は、生成モデルなど機械学習アルゴリズムの重要な構成要素にもなっている。
▶ AI・機械学習論1
5.7.1. \(\clubsuit\) おまけ: 多変数正規分布#
上の正規分布の考え方を拡張して、多変数の場合を考えることもできる。
2つ以上の変数であることを明示的に表すため、多次元正規分布や多変数正規分布などと呼ばれることが多い。
1次元の正規分布が、中心と分散(あるいは標準偏差(分散の平方根))で特徴づけられたのに対し、多次元正規分布は、中心(ベクトル)と共分散(行列)によって特徴づけられる。
\(N\)個の変数が、平均を \(\boldsymbol{\mu}\) ,共分散を \(\Sigma\) とする\(N\)次元正規分布に従うとき、\(\boldsymbol{x}\)の確率密度関数は
で与えられる。 \(\boldsymbol{x}\)←がフォントの設定や環境によってうまく太字にならないが、多成分(ベクトル)のつもりで読んでほしい。
二次元の場合に、適当な\(\mu\)と\(\Sigma\)を取って、多次元正規分布からサンプルしてみよう。
ここでは共分散行列 \(\Sigma\) が正定値で、逆行列が存在する場合を考える。\(|\Sigma|\) は行列式を表す。
mu1 = [3.0, 2.0]
cov1 = [[1.0, 0.7], [0.7, 1.0]]
mu2 = [-2.0, -0.5]
cov2 = [[0.6, -0.3], [-0.3, 1.0]]
numS = 50000

sample1 = np.random.multivariate_normal(mu1, cov1, numS)
sample2 = np.random.multivariate_normal(mu2, cov2, numS)

x1, y1 = sample1.T
x2, y2 = sample2.T
散布図にすると
fig = plt.figure(figsize=(10, 5))
ax = fig.add_subplot(111)
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.scatter(x1, y1, s=5, color="green", alpha=0.2, label="sample 1")
ax.scatter(x2, y2, s=5, color="orange", alpha=0.2, label="sample 2")
ax.scatter(mu1[0], mu1[1], marker="x", color="blue", alpha=0.9, label="mean 1")
ax.scatter(mu2[0], mu2[1], marker="x", color="red", alpha=0.9, label="mean 2")
ax.legend()
plt.show()
plt.close()
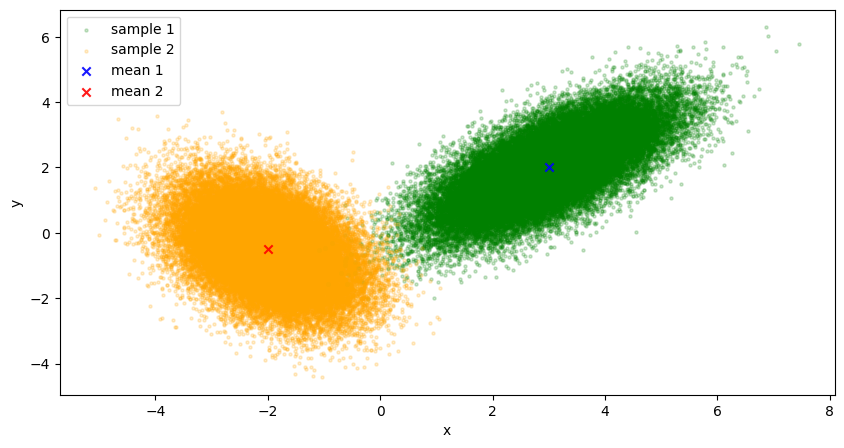
こんな感じ。
二次元のヒストグラムにすると
import matplotlib.cm as cm

fig = plt.figure(figsize=(12, 4))
ax1 = fig.add_subplot(121)
H1 = ax1.hist2d(x1, y1, bins=40, cmap=cm.jet)
ax1.scatter(mu1[0], mu1[1], s=80, color="w", marker="x")
ax1.set_title("sample1")
ax1.set_xlabel("x")
ax1.set_ylabel("y")
plt.colorbar(H1[3], ax=ax1)

ax2 = fig.add_subplot(122)
H2 = ax2.hist2d(x2, y2, bins=40, cmap=cm.jet)
ax2.scatter(mu2[0], mu2[1], s=80, color="w", marker="x")
ax2.set_title("sample2")
ax2.set_xlabel("x")
ax2.set_ylabel("y")
plt.colorbar(H2[3], ax=ax2)
plt.show()
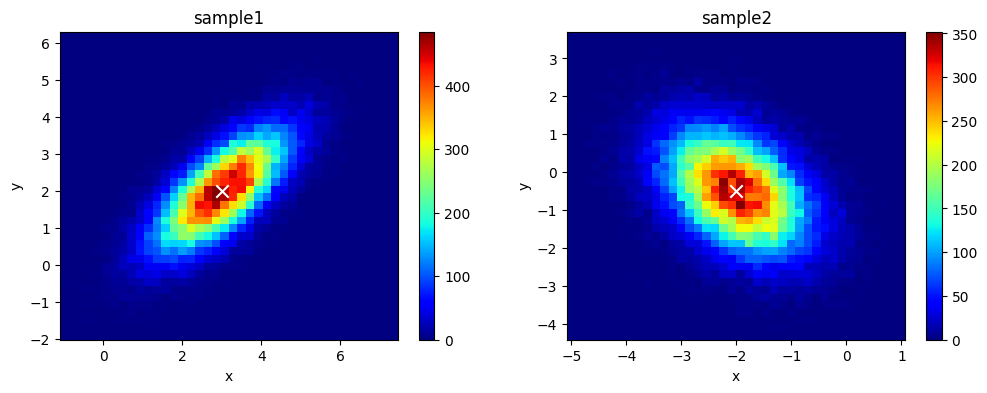
中心付近にたくさん分布している様子が見て取れる。
各サンプルごとに、\(x\),\(y\)の分散、共分散を計算してみると...
print("Sample1")
print("var(x)", np.var(x1, ddof=1), "var(y)", np.var(y1, ddof=1), "cov(x,y)", np.cov(x1, y1)[0, 1])

print("Sample2")
print("var(x)", np.var(x2, ddof=1), "var(y)", np.var(y2, ddof=1), "cov(x,y)", np.cov(x2, y2)[0, 1])
Sample1
var(x) 1.0038662193682288 var(y) 1.0040496995809747 cov(x,y) 0.7034726814010862
Sample2
var(x) 0.6039235338812055 var(y) 1.009596996580485 cov(x,y) -0.30563012356112573
上で与えた共分散行列の各成分に近い値が得られた。有限個のサンプルからの計算なので、ぴったり一致するわけではない。ここでは np.cov の既定値と揃えて、分散にも ddof=1 を指定した(割る数を \(N-1\) にする)。
ちなみに...サンプルを使うのではなく、
式から計算される値をつかって3次元の図を描くと
nmesh = 256
x = np.linspace(-6, 6, nmesh)
y = np.linspace(-6, 6, nmesh)
X, Y = np.meshgrid(x, y)


def gaussian_2d(X, Y, mu, cov):
    # 指数部分に入るのは共分散行列そのものではなく、その逆行列
    inv_cov = np.linalg.inv(cov)
    dx = X - mu[0]
    dy = Y - mu[1]
    quadratic = inv_cov[0, 0] * dx**2 + 2 * inv_cov[0, 1] * dx * dy + inv_cov[1, 1] * dy**2
    return np.exp(-0.5 * quadratic) / (2 * np.pi * np.sqrt(np.linalg.det(cov)))


Z = gaussian_2d(X, Y, mu1, cov1)
Z2 = gaussian_2d(X, Y, mu2, cov2)
from mpl_toolkits.mplot3d import axes3d

fig = plt.figure(figsize=(20, 6))
axL = fig.add_subplot(121, projection="3d")
axR = fig.add_subplot(122, projection="3d")

axL.set_xlabel("x")
axL.set_ylabel("y")
axL.set_zlabel("f(x,y)")
axL.view_init(azim=-110, elev=60)
axR.set_xlabel("x")
axR.set_ylabel("y")
axR.set_zlabel("f(x,y)")
axR.view_init(azim=-110, elev=60)

axL.plot_surface(X, Y, Z, cmap=cm.jet)
axR.plot_surface(X, Y, Z2, cmap=cm.jet)

plt.show()
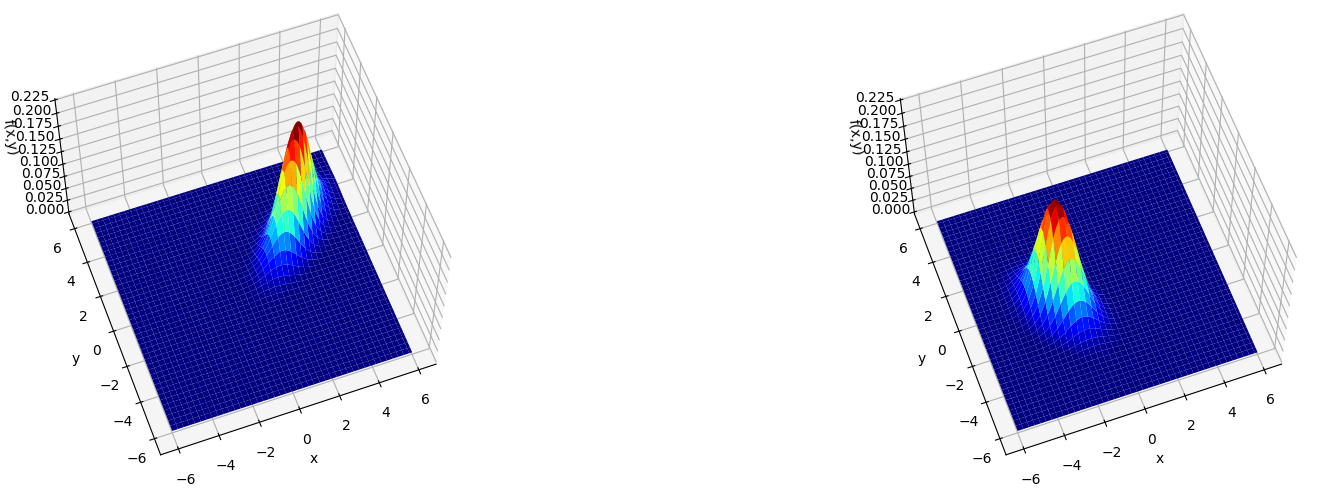
こんな感じ。
x,yのメッシュ点をいっぱいつくって、各点でのzの値を定義に則って計算し、z=f(x,y)の値に応じて色をつけている.
5.8. \(\clubsuit\) ランダムウォーク(酔歩)#
ここまでの乱数の生成方法を応用すると、ランダムウォーク(酔歩)と呼ばれるものを実装することもできる。
あなたは原点(0,0)に立っていて、毎秒ごとに[-1,1]の一様乱数に従ってx方向とy方向に移動するとする。 T秒後に立ってる場所や、軌跡をプロットしてみよう。
import numpy as np

xy = np.array([0.0, 0.0])  # 開始地点
T = 1000  # stepの数

random.seed(1234)  ## 同じ答えにしたければ乱数を固定しておく
trajectory = [[xy[0], xy[1]]]  # 開始地点も軌跡に含める
for step in range(T):
    xy += np.array([random.uniform(-1, 1), random.uniform(-1, 1)])
    trajectory += [[xy[0], xy[1]]]
trajectory = np.array(trajectory).T

fig = plt.figure(figsize=(5, 5))
plt.scatter(0, 0, marker="x", color="black", label="t=0")
plt.scatter(xy[0], xy[1], marker="x", color="red", label="t=" + str(T))
plt.plot(trajectory[0], trajectory[1], color="blue", linewidth=1, alpha=0.3)
plt.legend()
plt.show()
plt.close()
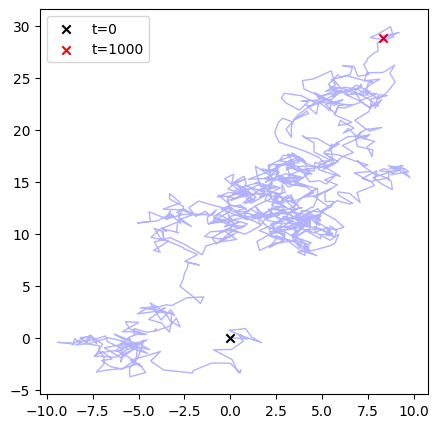
今の場合、x方向y方向いずれも、特別な方向への指向はなく完全にランダムに動いているが、獲得関数や勾配といったものが定義されるとさらなる応用が考えられる。
たとえば、地図に載っていない山があったと仮定して、その山の頂上にたどり着くためには、上のようなランダムウォークでは効率が悪いので、山の傾斜の情報(勾配)を利用しながらランダムな大きさで進む、といった方法が思いつく。
大きさをランダムにすることで、局所的な峠に捕まることを避けることもできるかもしれない(場合による).
\(\clubsuit\)進んだ注
ランダムウォークやその派生の方法は、最適化や確率分布からのサンプリングが必要な状況下でよく用いられ、統計学、自然科学、機械学習など様々な分野で活躍している。c.f. サンプリング, マルコフ連鎖モンテカルロ法, etc.