
6. 相関・回帰分析#
相関関係は因果関係を含意しない (Correlation does not imply causation)
[この章の目的] 初歩的な相関分析と回帰分析がPythonで出来るようになる。
今回使用するライブラリを準備しておこう。次のセルで、日本語表示に使うライブラリのインストールも行う。
%pip -q install japanize-matplotlib

from matplotlib import pyplot as plt

# 日本語フォントの設定
import japanize_matplotlib
import numpy as np
Note: you may need to restart the kernel to use updated packages.
6.1. 相関分析 (復習)#
高校数学のデータの分析やデータサイエンス入門などでも学習する相関分析について扱う。
解析したいデータが2種類だけなら、プログラムを使うご利益はそれほど感じられないが「多くのデータ間の相関関係を系統的に調べたい」「複数年度に渡るデータを解析したい」
あるいは「その結果をベクタ画像として出力したい」となると、これまで学習してきた繰り返し操作や作図が役に立つ。
まずは簡単な例から始めよう。
x = [3.1, 4.3, 6.6, 13.2, 19.1, 20.9, 26.4, 25.1, 21.9, 15.7, 9.6, 3.8]
y = [568, 572, 804, 833, 930, 965, 1213, 1120, 835, 540, 451, 502]
上に示したのは、2017年の宇都宮市における月別の平均気温\(x\)と世帯ごとのアイスクリーム・シャーベットの平均消費金額\(y\)で、散布図にすると↓こんな感じ
plt.figure(figsize=(6, 6))
plt.title("宇都宮市")
plt.xlabel("平均気温 (℃)")
plt.ylabel("世帯あたりのアイスクリーム・シャーベットの消費金額 (円)")
plt.scatter(x, y)
plt.show()
plt.close()
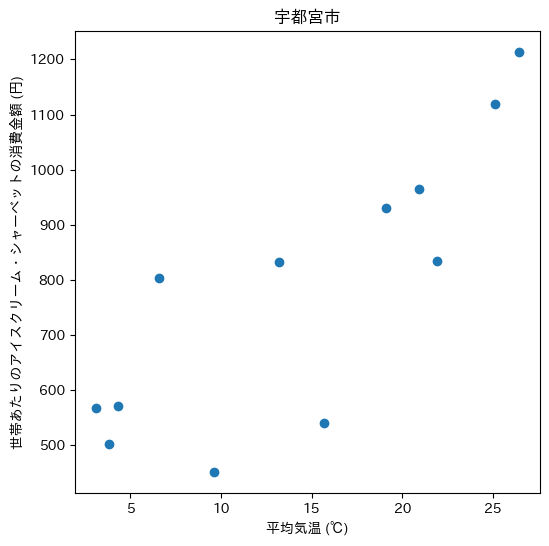
「平均気温とアイスの消費には相関がありそう」という直感の通り、正の相関があることが見て取れる。
では"どれほどの"相関を持つかを表す量として相関係数を算出してみよう。
相関係数\(r\)は以下のように定義され
\(\bar{x},\bar{y}\)はそれぞれ\(x,y\)の平均値で
と書ける。
下付き添字\(i\)は\(x\)の\(i\)番目の要素であることを表し(つまり\(x\)をn次元ベクトルとみなしたときの第\(i\)成分が\(x_i\))
今考えているデータの場合、\(\sum\)の和記号は\(i\)は1から12までの値を取り、対応する値を足し上げることを意味する。("\(i\)の和が1から12までを走る"と言ったりもする)
\(r\)は必ず-1から1までの値を取り1.0(-1.0)に近づくにつれ強い正(負)の相関を示す。
(強いというのは曖昧な表現で絶対的な線引がある訳では無いことに注意)
\(|r|\leq1\)は、コーシーシュワルツの不等式を用いるか
上の\(r\)の定義と\(n\)次元ベクトル同士の内積の定義とを見比べると示せる(暇があればやってみよう)。
次にxとy、2つのリストを引数に持ち、相関係数\(r\)を返す関数を作成してみよう。
にらめっこするために式を再掲:
この相関係数は直線的な関係の強さを表す。どちらか一方がすべて同じ値なら分母が0になり、定義できない。また、\(r\) が0に近くても、曲線的な関係がある場合はある。
### ライブラリを一切使わない方法
def cor_coeff(x, y):
    # 対応するデータが2組以上あることを確認 (おまけ)
    if len(x) != len(y) or len(x) < 2:
        raise ValueError("Error: x&y must satisfy len(x) = len(y) >= 2")

    n = len(x)
    ## 平均を計算
    xbar = sum(x) / n
    ybar = sum(y) / n

    ##分子(numerator)の和を計算 (初期値を0にしてループで加算していく)
    s_n = 0.0
    for i in range(n):
        s_n += (x[i] - xbar) * (y[i] - ybar)

    ##分母(denominator)の計算 (和を先に計算して積を取り、最後にsquare rootをとる)
    s_x = 0.0
    s_y = 0.0
    for i in range(n):
        s_x += (x[i] - xbar) ** 2
        s_y += (y[i] - ybar) ** 2
    s_d = (s_x * s_y) ** 0.5
    # 一行で書くならリスト内包表記を用いて以下のようにも書ける
    # s_d = ( sum([(x[i]-xbar)**2 for i in range(n)]) * sum([(y[i]-ybar)**2 for i in range(n)]) )**0.5

    if s_d == 0:
        raise ValueError("各リストには異なる値が少なくとも2つ必要です。")
    return s_n / s_d


cor_coeff(x, y)
0.8262304630498378
という風に、\(r\)が約0.83で、非常に強い正の相関を示すことが分かる。
少しずつ自作関数に慣れてきたら、上のように意図しない引数を入れたときの挙動なども設定すると
より安全なコードを作る事ができる。
xとyの長さが違う場合(上のraise文でエラーを生じさせる場合)を試しておこう。
cor_coeff(x, y[1:])
---------------------------------------------------------------------------
ValueError                                Traceback (most recent call last)
Cell In[5], line 1
----> 1 cor_coeff(x, y[1:])

Cell In[4], line 5, in cor_coeff(x, y)
      2 def cor_coeff(x, y):
      3     # 対応するデータが2組以上あることを確認 (おまけ)
      4     if len(x) != len(y) or len(x) < 2:
----> 5         raise ValueError("Error: x&y must satisfy len(x) = len(y) >= 2")
      7     n = len(x)
      8     ## 平均を計算

ValueError: Error: x&y must satisfy len(x) = len(y) >= 2
相関係数の計算は、numpyライブラリを使うと実はもう少しシンプルに書ける
def cor_coeff_np(x, y):
    x = np.asarray(x, dtype=float)
    y = np.asarray(y, dtype=float)
    if x.ndim != 1 or y.ndim != 1 or len(x) != len(y) or len(x) < 2:
        raise ValueError("同じ長さの1次元データを2組以上指定してください。")
    xbar = np.mean(x)
    ybar = np.mean(y)
    denominator = np.sqrt(np.dot(x - xbar, x - xbar) * np.dot(y - ybar, y - ybar))
    if denominator == 0:
        raise ValueError("各配列には異なる値が少なくとも2つ必要です。")
    return np.dot(x - xbar, y - ybar) / denominator


cor_coeff_np(x, y)
0.8262304630498378
引数の確認などは少し長いが、和を求めるループを書かずに計算できた。短く書くこと自体が目的ではないので、数式との対応が分かる形にしておこう。
上のコードを少し補足しておくと...分子や分母に現れる\(\sum_{i=1}^n (x_i-\bar{x})(y_i-\bar{y})\)や\(\sum_{i=1}^n (x_i-\bar{x})^2 \)といった項は、
\(i\)番目の成分に\(x_i-\bar{x}\)を持つベクトル\(\tilde{x}\)と\(i\)番目の成分に\(y_i-\bar{y}\)を持つベクトル\(\tilde{y}\)を定義しておくと、
\(\tilde{x}\cdot\tilde{y}\), \(\tilde{x}\cdot\tilde{x}\), \(\tilde{y}\cdot\tilde{y}\)といったように、ベクトルの内積の形でいずれも表すことができる。
numpyにはブロードキャスト機能(NumPyのノートを参照)や内積を計算する関数dotが備わっているので、
それらを活用することで相関係数の計算を短く実装することができた。
更に言うと実はnumpyには相関係数を計算する関数corrcoef()が予め用意されていて
print(np.corrcoef(x, y))
print("r(x,y)=", np.corrcoef(x, y)[0, 1])
[[1.         0.82623046]
 [0.82623046 1.        ]]
r(x,y)= 0.8262304630498377
を使えば
[ xとxの相関(=1.0), xとyの相関;
yとxの相関, yとyの相関(=1.0)]
といった2行2列の相関行列を取得することが出来る。
確かに上の相関行列の[0,1]成分は、さっき計算した\(r\)の値と一致している。
「初めからそれを教えろ!」と思うかもしれないが
考えたい量を数式として定義してそれをプログラムに変換し、値が正しいことを確認する作業は
式(考え方)とプログラミング双方の理解を深める上で非常に重要になる。
6.1.1. 相関分析と因果関係#
以下では、ある一つのグラフの例を見ながら、冒頭の*相関関係は因果関係を含意しない (Correlation does not imply causation)*に関して説明する。
下の図は、2017年の家計調査・気候データから作成した散布図で、千葉市での平均気温と、しめじの消費支出の間の相関を示している。
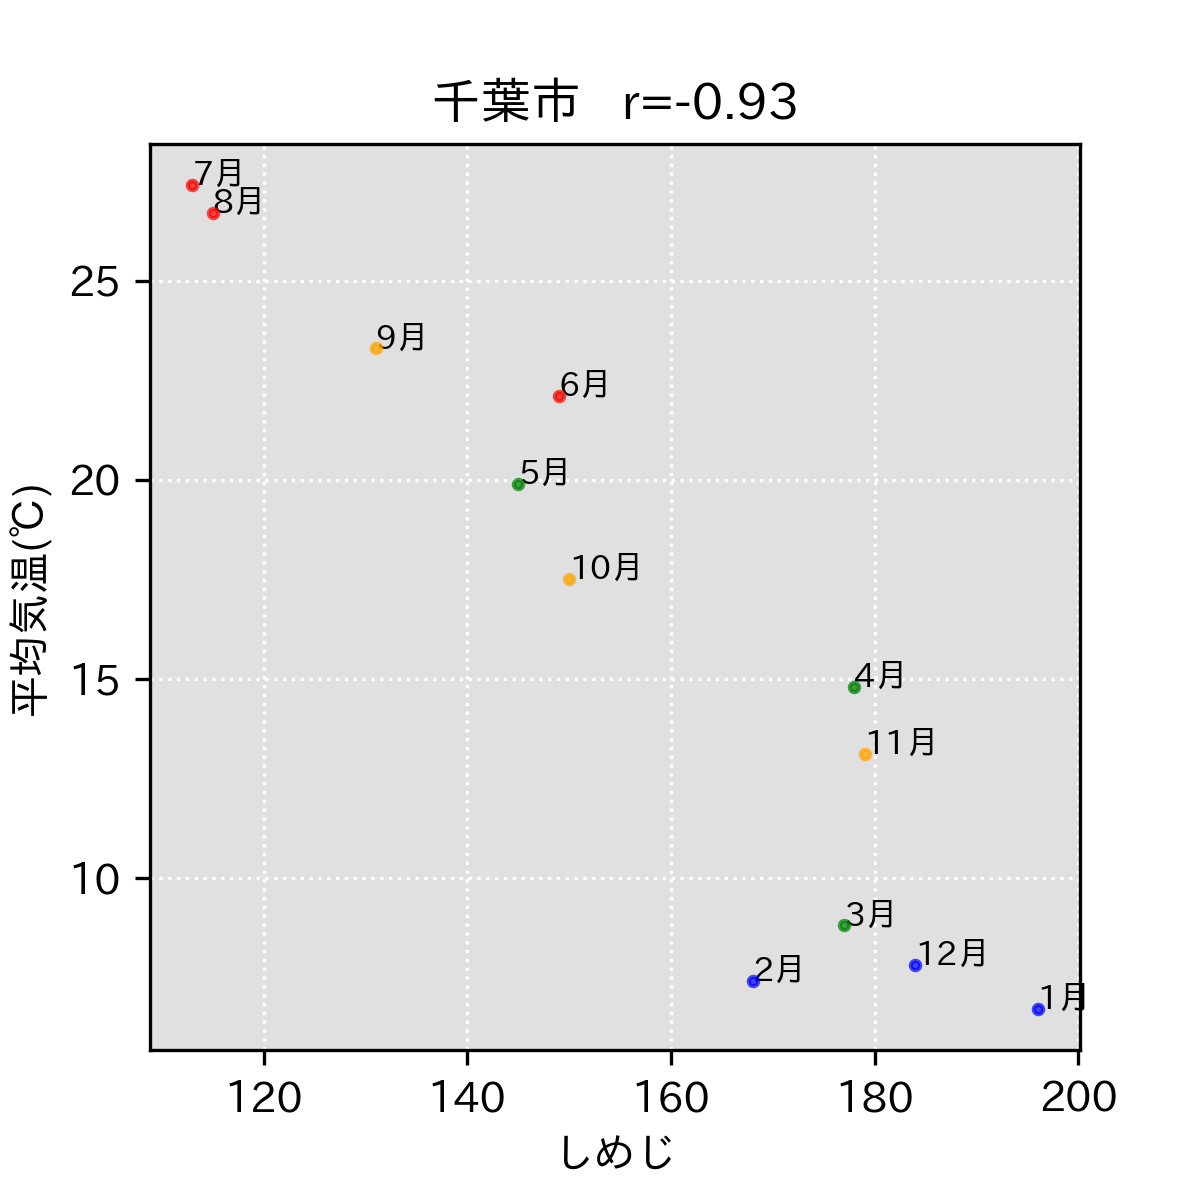
消費支出と平均気温の間に、強い負の相関が見て取れるが、これはどうしてだろうか? 「寒い季節には鍋が食べたくなるから」と言われるとふむふむと感じる一方で、「そもそも生産量が冬に多く、市場に出回る量が多いから」と考えることもできる。したがって、このデータを見ただけでは、しめじが冬によく売れる理由までははっきりとは分からない。
ただし、この図の縦軸は購入量そのものでも購買意欲でもなく、支出金額である。価格の変化によって支出が変わることもある。季節と一緒に変わる条件を、気温の効果と取り違えないようにしたい。
気温と特定の野菜の購買意欲の真の関係を知りたければ、「その野菜はビニールハウスなどの生産設備の向上で年中、安定した味で生産ができる」「比較的新しい品種で〇〇といえば秋、のような固定観念がない」「季節ごとの生産量がほぼ同じ」など、他の条件が揃った状況下で比較しなければ確度の高い議論は難しい。
このように、因果関係を紐解くことは、我々が思うほど容易ではなく、それ自体が一つの学問分野になっている。気になった方は、たとえば"因果推論"で調べてみよう。
疑似相関をまとめたおもしろいサイトのように顕著な例ならば「あぁ疑似相関だな」と気がつくが、我々が普段見ている情報の中には、疑似相関であるとひろく認識されていない情報もあるはず。 物事の因果関係を断定するような言説に対しては一歩引いて見る姿勢も重要なように思う。
6.2. 回帰分析#
以下では自分が立てたモデルを表現する関数のことをモデル関数、モデル関数とデータとの齟齬を最小化するようにモデル関数の係数を決定することを回帰、そして回帰に基づく分析を指して回帰分析と呼ぶことにする。
この授業では、\(x\)に対する\(y\)の振る舞い、といういわゆる単回帰分析のみを扱う。
データとモデル間の齟齬を表現する方法はいくつかあるが、以下では最もポピュラーな誤差の二乗和を採用することとし、その最小化を考える(最小二乗法)。データや関数、最小二乗法をもう少しきちんと定義しよう。
\(D\)個の点\(\{x_1,x_2,...,x_D\}\)でのyの値\(\{y_1,y_2,...,y_D\}\)が観測されているとき、
最小二乗法とは、ある決められたモデル関数\(f(x)\)との齟齬
を最小化するように関数\(f\)の係数を調整すること。
以下では、\(f(x)\)として単純な多項式のみを考えることにする。
\(f\)自体をどう決める/設計するかも重要な話題だが、この授業では深入りしない。
まず回帰を学ぶために、適当なデータを生成しておく。
"""
0,1で定義された区間でsample_size(int)個の点で
sin関数に正規乱数に従う誤差を加えた値を返す関数。
- sample_size: データの数
- std: standard deviation (標準偏差σ)
"""


def create_toy_data(sample_size, std):
    x = np.linspace(0, 1, sample_size)
    t = np.sin(2 * np.pi * x) + np.random.normal(scale=std, size=x.shape)
    return x, t


# 私と皆さんで結果が変わらないよう乱数のseedを固定
# randomモジュールの関数を使うときはrandom.seedを、numpyのrandom関数を使うときはnp.random.seedを用いる
np.random.seed(1234)

x, y = create_toy_data(10, 1.0e-1)
これをグラフにしてみると...
fig = plt.figure(figsize=(10, 4))
ax = fig.add_subplot(111)
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.scatter(x, y, facecolor="none", edgecolor="b", s=50, label="Data")
ax.legend()
plt.show()
plt.close()
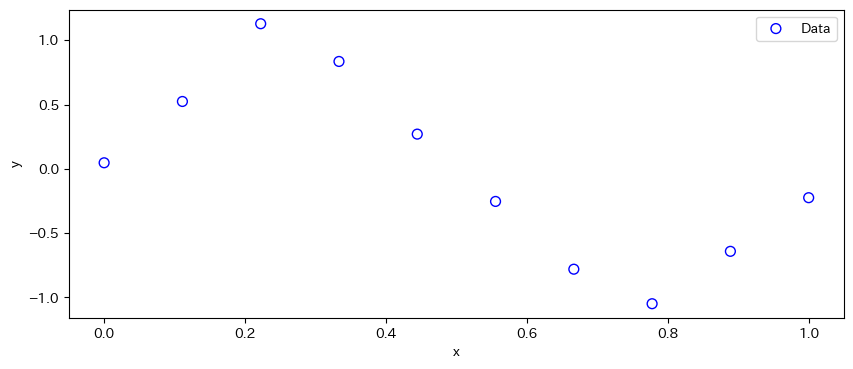
こんな感じ。
このデータを、\(p\)次の多項式(p=0,1,2,...)を最適化することを考えてみよう。
\(p\)次式は、\(p+1\)個の係数, \(a_0\)から\(a_p\)を使って
\(a_0 + a_1x + a_2x^2\cdots +a_p x^p \)と書くことが出来る。
上で定義した最小二乗法は、この関数と各データ点との二乗誤差の和を最小にする係数\(a_0,a_1,...,a_p\)を求めることに相当する。
\(p\)次の多項式の最適化は、実はnumpyにある関数polyfit()を利用すれば簡単に実行できる。
他にもscikit-learnなどのライブラリもより高度な関数のフィッティングが可能。
\(\clubsuit\)進んだ注:
多項式で回帰を行う場合には、実はパラメータの最適解は"閉じた形"で与えられる。
この辺りのことは、おまけのノートブック:ベイズ線形回帰で詳しく書いています。
なお"閉じた形"というのは、数学や物理をやっていると出てくる表現で、答えが具体的な形で書き下せる、程度の意味。
たとえば 行列\(A\)、ベクトル\(\vec{x},\vec{y}\),スカラー\(\lambda\)について方程式\(A\vec{x}=\lambda \vec{y}\)が成り立つとき、\(A\)が可逆であるとして、逆行列をどうやって求めるか(数値的にやるのか解析的に求めるのか)はさておき、\(\vec{x} = \lambda A^{-1}\vec{y}\)と書き直せるので「\(\vec{x}\)は閉じた形で与えられる」と言ったりもする。
6.2.1. polyfit/poly1d関数#
たとえば今のデータを3次式でフィットしたければ、以下のようにする。
## 多項式をplotするためのxの値を準備(グラフをなめらかにするために、0から1までの間の500点を等間隔に作る)
xp = np.linspace(0, 1, 500)

# 多項式の次数pを決める. 今は3次式.
p = 3

# polyfit関数で最適化し、返り値(係数)を取得する
coeff = np.polyfit(x, y, p)

# 最適化された係数と、1次元入力xに対する多項式を計算してくれるpoly1d関数を用いて描画点xpでのモデル関数の値を計算する。
yp = np.poly1d(coeff)(xp)

print("係数", coeff)
係数 [ 1.94608261e+01 -2.96846442e+01 1.01048487e+01 -2.79806869e-02]
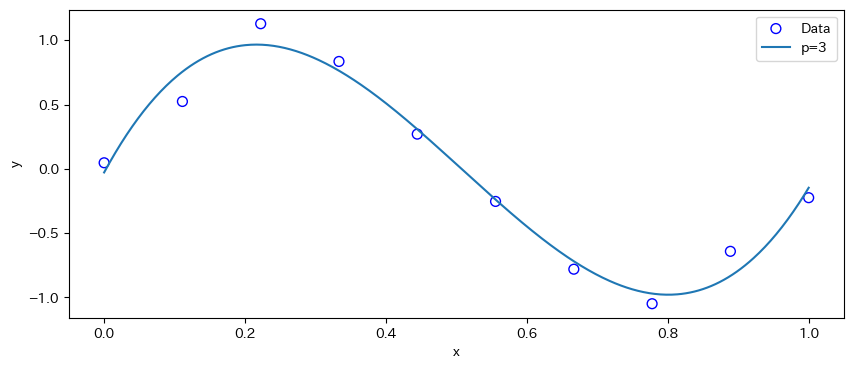
np.polyfit(x, y, p):データのx,yの値と多項式の次数pを引数として与え\(p\)次の多項式でデータ\((x,y)\)をfitしなさい(\(p\)次までの係数を関数がデータと整合するように"最適化"しなさい)という指令になっている。
np.poly1d( np.polyfit(x, y, p) )(xp):fitで得られた係数をもつp次多項式に
xp(今は500点)を代入して、対応するyの値を返す。
上のコードはこの返り値をypという変数に格納している。
最後に、printで調整(最適化)された3次式の係数を表示してみた。
ちなみに、表示される係数は次数が高いところから\(a_3,a_2,a_1,a_0\)です(ややこしいね...)。
グラフを描いてみるとこんな感じ。
# お絵かき
fig = plt.figure(figsize=(10, 4))
ax = fig.add_subplot(111)
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.scatter(x, y, facecolor="none", edgecolor="b", s=50, label="Data")
ax.plot(xp, yp, label="p=3")
ax.legend()
plt.show()
plt.close()
さて、\(p\)次の多項式は\(p-1\)次の多項式を特別な場合として含むため、一般に\(p\)(多項式の次数)を増やせば、より複雑な関数を表現することができる。(2次式は3次式の\(a_3=0\)の場合ですよね?)
\(p\)を複数変えながら比較した図を作ってみよう。その方法は、\(p\)に関するループを回すだけ。
ps = [0, 1, 3, 6, 9]
xp = np.linspace(0, 1, 500)

# 各pでのfitの結果(xpでの対応する値のリスト)をysに入れ子のリストにしていく
ys = []
for p in ps:
    ys += [np.poly1d(np.polyfit(x, y, p))(xp)]

# データの背後にある"真の関数"(本当は知り得ない)の値をxpの各点で計算
ytrue = np.sin(2 * np.pi * xp)

# お絵かき
fig = plt.figure(figsize=(12, 5))
ax = fig.add_subplot(111)
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.scatter(x, y, facecolor="none", edgecolor="b", s=80, label="Data")
for i in range(len(ps)):
    ax.plot(xp, ys[i], label="p=" + str(ps[i]), alpha=0.8)
ax.plot(xp, ytrue, linestyle="dotted", label="True", color="k")
ax.legend(loc="upper right")
plt.show()
plt.close()
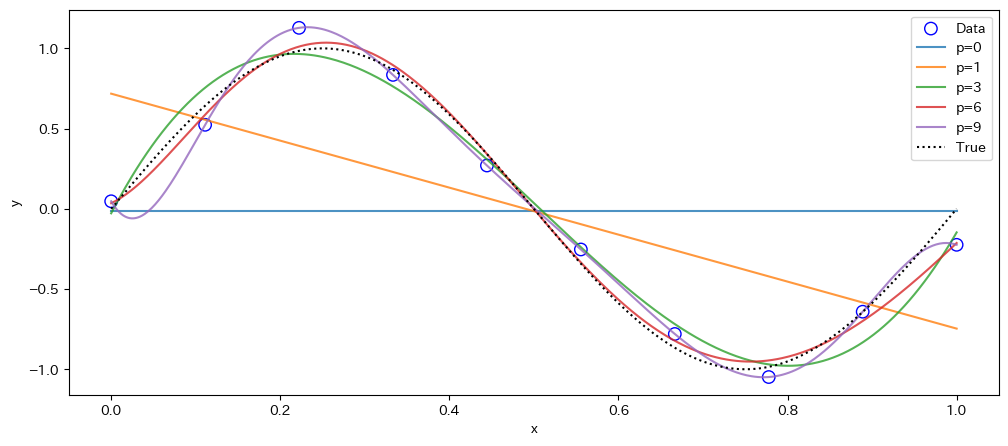
注: 今の場合、回帰に用いたデータはsin関数に適当なノイズを足して作られている。解析の手法を学ぶ際には、このように答えを知っている状態からはじめて、手法がうまくデータを説明しているかどうかを検証したりする。一見ズルっぽいが、理論を理解したりプログラムで確認するためには重要なプロセスとなる。
現実のデータ解析の状況では、背後にある"真の関数"が分かっていることは非常に稀で、「興味のあるデータが、人間がよく知っている単純な式(有限次数の多項式や指数関数)で完全に表現できる道理はない」ということも押さえておくべき重要な点となる.真の関数というのは一般に神のみぞ知るで、人間ができることは、出来るだけ尤もらしい関数を見つけ、その背後にあるメカニズム(の主要部分)を解明することと言える.
一般に、関数をどんどん複雑なものにしていくにつれて、関数の表現力(表現できるデータの幅)は大きく拡がる。
その一方で、用意した関数がデータに過度に適合するあまり、未知の点での値の予測精度(汎化性能)が著しく損なわれている危険性がある。
このことを予言能力がない(データに過適合している) と言う。
回帰に使わなかったデータで予測を確かめたり、背後のメカニズムと照らし合わせたりして、関数の妥当性を検証する必要がある。
6.2.2. \(\clubsuit\) モデルの複雑さとモデル選択#
上の多項式回帰では、たとえば9次式はデータをピッタリと再現している一方で真の関数(sin関数)の振る舞いよりもむしろ、測定誤差のようなものにまで過適合してしまっている。ここで過適合を防ぐためにデータとの整合性(二乗誤差)だけでなくモデルの複雑さも定量化し、なるべく複雑すぎない関数が選ばれるよう勘定することを考える。
ここではこのモデルの複雑さ\(C\)として多項式の係数の二乗和の平方根: \(C= \sqrt{\sum_i |a_i|^2}\)を採用することにしよう。
さらに、"モデルを選択するための基準\(L\)"を\(L = \)(二乗誤差) + \(\lambda\) \(\log_{10}(1+C)\)で定量化し、この\(L\)が最小になる多項式を採用することにしよう。(この選択はあくまで例であることに注意)
各次数での多項式のモデルの複雑さ\(C\)と二乗誤差、そしてモデル選択基準量\(L\)を表示してみると...
1 + C とするのは、すべての係数が0でも対数を計算できるようにするためである。
def complexity(r):
    return np.sqrt(np.dot(r, r))


def my_criteria(comp, err, lam=1.0):  # lambda=1.0
    return err + lam * np.log10(1 + comp)


for p in ps:
    coeff = np.polyfit(x, y, p)
    diff = np.poly1d(coeff)(x) - y
    chi2 = np.dot(diff, diff)
    comp = complexity(coeff)
    print(
        "p",
        p,
        "log10(1+C)→",
        np.log10(1 + comp),
        "二乗誤差",
        chi2,
        "モデル選択基準量",
        my_criteria(comp, chi2),
    )
p 0 log10(1+C)→ 0.006195689706789331 二乗誤差 4.550066082907134 モデル選択基準量 4.556261772613923
p 1 log10(1+C)→ 0.4201017325526253 二乗誤差 2.365858853559421 モデル選択基準量 2.7859605861120462
p 3 log10(1+C)→ 1.5787014028366546 二乗誤差 0.14507849283252533 モデル選択基準量 1.7237798956691799
p 6 log10(1+C)→ 2.7134073791236966 二乗誤差 0.049206739971584715 モデル選択基準量 2.7626141190952813
p 9 log10(1+C)→ 4.192653051887607 二乗誤差 4.128205948561372e-23 モデル選択基準量 4.192653051887607
9次式は、データをよく説明する一方で、非常に複雑なモデルになっている。
上記のモデル選択基準量\(L\)は\(p=3\)で最小となるため、この\(L\)の定義のもとでは3次式が選ばれることになる。
このように実際のデータ分析や機械学習などのモデル選択では、既知のデータの記述能力(二乗誤差の最小化)とモデルの複雑さの低減(過適合を避ける)との トレードオフでモデルを選択することも多い。
上の\(L\)の定義中の\(\lambda\)の大きさを変えることは、"データとの整合性を高める"のか、"モデルの複雑さを抑える"のか、 どちらを重視するかの"度合い"を決めることに相当している。(\(\lambda\)を適当に変えてみよう)
モデルの複雑さに罰則を課して学習する方法は正則化と呼ばれる。ただし、上の例では各多項式を通常の最小二乗法で求め、その後で独自の基準で比較している。正則化項を加えた目的関数そのものを最小化したわけではない。また、係数の大きさは入力の単位や基底にも依存するので、この基準がいつでも使えるわけではない。
6.2.3. 予言能力のない例: 100メートル走のタイム#
予言能力がないモデルとして、以下の例を考えてみよう。
y = [
    10.06,
    10.03,
    10.02,
    9.95,
    9.93,
    9.92,
    9.9,
    9.86,
    9.85,
    9.84,
    9.79,
    9.78,
    9.77,
    9.74,
    9.72,
    9.69,
    9.58,
]
x = [
    1964,
    1968,
    1968,
    1968,
    1983,
    1988,
    1991,
    1991,
    1994,
    1996,
    1999,
    2002,
    2005,
    2007,
    2008,
    2008,
    2009,
]

fig = plt.figure(figsize=(12, 3))
ax = fig.add_subplot(111)
ax.set_xlabel("year")
ax.set_ylabel("Mens 100m")
ax.scatter(x, y, marker="o", color="red")
plt.show()
plt.close()
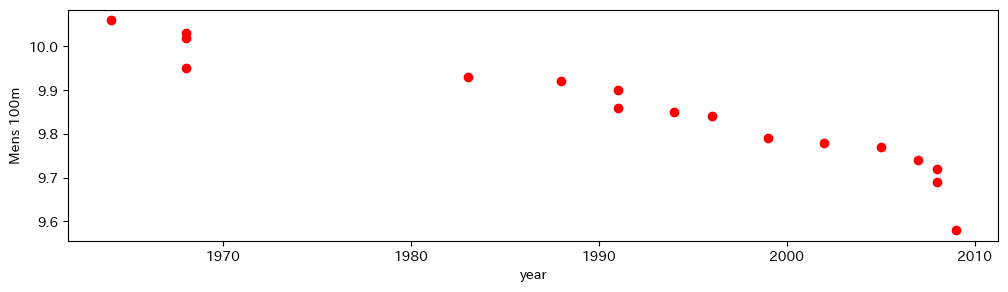
図にしたのは、教材に保存された男子100mの記録の推移(1964〜2009年).
このデータに対して「\(p=3\)の多項式でフィットして予測する」という立場をとってみる。
この系列には、後に取り消された2002年の9.78秒も含まれる(World Athleticsによる取り消しの告知)。ここでは元の数値例を保って外挿の問題を考えるために使う。公式の世界記録一覧としては扱わない。
xp = np.arange(2020, 2101, 1)
fig = plt.figure(figsize=(12, 6))
ax = fig.add_subplot(111)
ax.set_xlabel("year")
ax.set_ylabel("Mens 100m")
ax.set_xlim(1960, 2100)
ax.set_ylim(0, 12)
for p in [3]:
    yp = np.poly1d(np.polyfit(x, y, p))(xp)
    ax.plot(xp, yp, marker="x", label="p=" + str(p))
ax.scatter(x, y, marker="x", color="red")
ax.legend(loc="upper right")
plt.show()
plt.close()
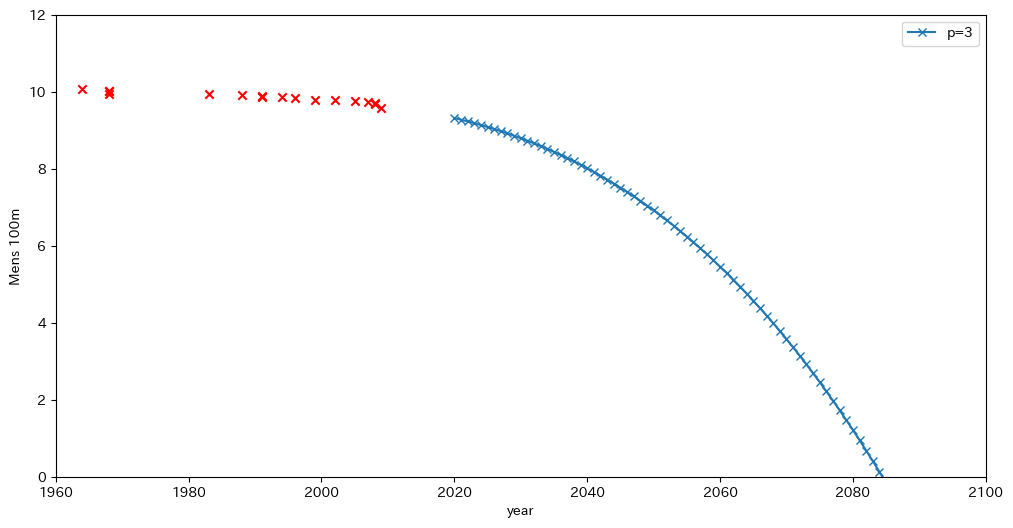
2080年代には100m走のタイムがゼロになってしまうおかしな予測だと気がつく。
今の場合、我々はこのデータが100m走の世界記録のタイムの推移であること、つまり
非増加関数であること
必ず正の値であること
など、データが持つべき性質を予め知っているので、
「このデータに対して単純な多項式回帰を当てはめるのはおかしい」
と気がつくことが出来る。
でも、他のデータではどうだろう?
データを分析するためには、データの値だけをみて闇雲に分析するだけではダメで、データの背景やドメイン知識が不可欠である、という好例。
6.2.4. 回帰分析における注意点: 感染症の罹患者数を例に#
我々が現実世界で観測することのできる種々の"値"というのは、何らかの関数\(f(x)\)の、ある\(x\)での(実現)値と言える。
感染者数の推移は日付に対する関数として示される事も多い。
日付に対して陽性者数の推移をプロットして変動の予想を立てることは簡単だが、感染者数の推移も単なる時間に対する1変数の関数である道理などなく、
たとえば検査数や報道などの"空気感"、国・都道府県ごとの取り組み・政策、ウイルスの変異,その他様々な要素に左右される。
同じことは例えば株価や人間の行動などにも言える。
一枚の平面図や立体図の座標として直接表せるのは2〜3変数だが、色や図の並べ方などを工夫すれば、さらに多くの変数を比較することもできる。
言い換えれば、人間は物事を理解するときに本来D次元(D>>3, Dは3よりずっと大きい)の変数で定義される関数を、
3次元以下に射影した「影」をみて理解しようとする生き物だということは意識しておくべきだろう。
多項式に限らずより広範なクラスの関数を考えることはもちろんできる。
やみくもに無限の数の関数を考えれば、データに適合するものが存在してもおかしくはない。
が、そのような関数を見つけることができたとしても、それがデータの背後にあるメカニズムを説明しているとは限らない。
何にでも言えることだが、モデルを立てて終わり、ではなく検証し続ける姿勢が重要である。